Stackable
Now available: Managed Data Lakehouse → Sovereign, Compliant, Open Source. Try it free for 30 days.
Jetzt verfügbar: Managed Data Lakehouse → Souverän, Compliant, Open Source. 30 Tage kostenlos testen.
Machine Learning zur Ausreißererkennung
Unüberwachte Ausreißererkennung auf New Yorker Taxidaten: Apache Spark trainiert einen Isolation Forest, die Ergebnisse landen in Apache Iceberg und Superset visualisiert die Anomalien.
SO GEHT'S LOS
Mit einem Kubernetes-Cluster genügt ein einziger Befehl:
Funktionen
Unüberwachtes ML
Ein Isolation Forest braucht keine gelabelten Daten, um Ausreißer zu finden.
Iceberg-Ergebnisspeicher
Vorhersagen werden als offene Iceberg-Tabelle persistiert.
Reproduzierbar
Feste Images und deklarative Jobs machen Läufe wiederholbar.
Verteiltes Training
Spark skaliert den Trainingsjob über den Cluster.
Visuelle Prüfung
Superset stellt die markierten Ausreißer zur Inspektion dar.
Erweiterbar
Tausche mit wenig Aufwand dein eigenes Modell oder deinen Datensatz ein.
Demo-Komponenten
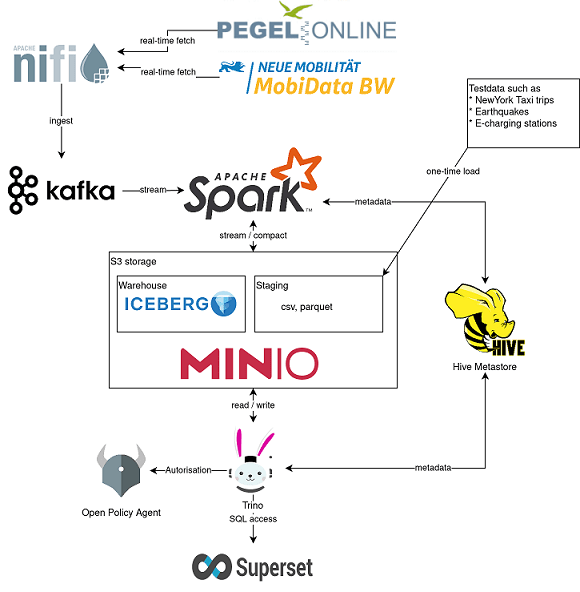
Apache Spark
ML-Compute
Trainiert das Isolation-Forest-Modell als verteilten Spark-Job.
Apache Iceberg
Ergebnisspeicher
Speichert die Modellvorhersagen als offene, abfragbare Tabelle.
Apache Superset
Visualisierung
Visualisiert die markierten Anomalien gegenüber den Rohfahrten.
MinIO
Data Lake
S3-kompatibler Objektspeicher, der den Taxi-Datensatz hält.
Demo-Ablauf
Installation
Ein Befehl installiert Spark, Iceberg-gestützten Speicher und Superset.
Taxidaten laden
Die Demo lädt den New Yorker Taxi-Datensatz in den Lake.
Spark-Job ausführen
Trainiere den Isolation Forest als verteilten Spark-Job.
In Iceberg schreiben
Persistiere die Anomalie-Vorhersagen in einer Iceberg-Tabelle.
Anomalien erkunden
Inspiziere die markierten Ausreißer im Superset-Dashboard.
Fahre eine vollständige ML-Batch-Pipeline auf der Plattform, vom Training bis zum Dashboard.