Logs, Metriken, Produktkataloge, Security-Events – sobald man in all diesen Daten schnell etwas finden muss, braucht es eine Suchmaschine, die skaliert. Der Stackable Operator betreibt OpenSearch, die Open-Source-Such- und Analytics-Engine auf Basis von Apache Lucene, Kubernetes-nativ. Node-Groups, Versionierung, Skalierung und Hochverfügbarkeit – alles deklarativ über CRDs verwaltet. Ob on-prem, air-gapped oder in einer souveränen Cloud – die Daten bleiben in eigener Hand.
Warum OpenSearch in der Stackable Data Platform (SDP)?
OpenSearch bringt Volltextsuche, Echtzeit-Indexierung und fortschrittliche Analytics direkt in die vorhandene Datenlandschaft. Statt ein weiteres Datensilo aufzubauen, indexiert es die relevanten Teile der Quellsysteme, während die Originaldaten die Single Source of Truth bleiben – Indizes lassen sich also jederzeit aus den darunter liegenden Systemen neu aufbauen.
Such- und Analytics-Funktionen auf Enterprise-Niveau
Eine Open-Source-Engine auf Apache Lucene – Volltextsuche, strukturierte Abfragen, Aggregation und Echtzeit-Insights.
Umfangreiche, integrierte Funktionen
Über die Suche hinaus vereint OpenSearch Vektorsuche, Anomalie-Erkennung, Observability und Security-Analytics in einer Plattform – eine natürliche Grundlage für KI-gestütztes Retrieval.
Skalierbar & performant
Für riesige Mengen unstrukturierter Daten ausgelegt, mit hohem Durchsatz, geringer Latenz und horizontaler Skalierung.
Breite Observability-Abdeckung
Integrierte Unterstützung für Log-Analyse, Performance-Monitoring und Threat-Detection macht OpenSearch ideal geeignet für Monitoring und Security-Analytics.
Offene Architektur & modulares Tooling
Komponenten wie Data Prepper (Ingestion und Transformation) und die Vector Engine (für AI/ML-Einsatz) unterstützen End-to-End-Daten-Workflows.
Offen & community-driven
Unter Apache 2.0 lizenziert und von einer Foundation mit breiter Community getragen.
Was bringt der Stackable Operator für OpenSearch mit?
Rollenbasierte Node-Pools
Dedizierte Role-Groups (cluster_manager, data, ingest, coordinating_only, search, warm) betreiben, jede unabhängig skaliert und getunt, damit Indexierungs-, Abfrage- und Analytics-Workloads nicht mehr um dieselben Ressourcen konkurrieren.
Vektorsuche und ML inkludiert
Das Stackable-Image bringt die k-NN- und ML-Plugins mit. Vektor- und semantische Suche, die Retrieval-Schicht hinter KI-Use-Cases, ist damit sofort verfügbar, ohne selbst Plugins nachzuinstallieren.
Mehrere Cluster parallel betreiben
Mehrere OpenSearchCluster-Ressourcen in einer Umgebung definieren, jede unabhängig verwaltet, um Dev, Staging und Produktion zu trennen oder Mandanten voneinander abzugrenzen.
Was haben alle Stackable-Operatoren gemeinsam?
Ein Operator-Framework (Rust)
Jeder Operator folgt demselben CRD-Muster mit Roles, RoleGroups und ConfigOverrides. Wer einen Operator kennt, findet sich sofort im nächsten zurecht.
Infrastructure-as-Code
Jede Data-App ist eine YAML-CRD, die in Git lebt – reviewbar, lintbar und CI/CD-fähig, mit eingebauten Validierungsregeln, die Fehlkonfigurationen früh abfangen. Dieselbe Definition funktioniert auf Dev, Test und Prod.
Lifecycle-Management (Day-2 Operations)
Deployment, Restarts, Zertifikatsrotation und Rolling Upgrades laufen automatisch – inklusive Pod-Restarts, wenn sich Configs oder Secrets ändern. Und weil man sehen muss, was läuft, ist Monitoring & Logging gleich mit dabei: Prometheus, Vector und OpenTelemetry speisen fertige Grafana-Dashboards – ein Observability-Setup für die ganze Plattform.
Security by default:
TLS, Kerberos für HDFS, OIDC-Login und OPA-basierte, feingranulare Autorisierung, alles pro CRD konfigurierbar. Tägliche Vulnerability-Scans, SBOMs und mit cosign signierte Images halten die ganze Plattform gepatcht – man muss nicht selbst ein Dutzend Upstream-Projekte im Blick behalten.
Kubernetes-native und modular
Läuft on-prem, in jeder Cloud oder auf einem Laptop, ohne Vendor-Lock-in – mit explizitem air-gapped Support. Nur die benötigten Operatoren installieren und später weitere hinzufügen, ohne den Rest anzufassen.
OpenShift-zertifiziert
Alle Operatoren sind Red-Hat-zertifiziert und direkt über den Red Hat Certified Operators Catalog (OperatorHub) installierbar – kompatibel mit Security Context Constraints und RBAC. Zertifizierter Betrieb über eine Stackable-Subscription.
Use Cases für OpenSearch
Log-Management & Observability
Milliarden Log-Einträge aus Apps, Infrastruktur und Security-Systemen, in Echtzeit indexiert – für die Überwachung des Systemzustands, schnelle Fehlererkennung und die Erfüllung von Compliance-Anforderungen. Stackable automatisiert das Cluster-Management, auch im Enterprise-Maßstab.
Security-Analytics & Threat-Detection
Security-Teams analysieren Event-Streams von Firewalls, Servern und Netzwerken und korrelieren Muster, um Anomalien und Bedrohungen sichtbar zu machen – auf Clustern, die hochverfügbar bleiben und sich mit wachsenden Daten leicht erweitern lassen.
Suche-basierte Customer Experience
Schnelle, relevante Produktsuche auf Basis von OpenSearch. Das Indexieren von Katalogen und Nutzerverhalten verbessert Conversion und Personalisierung.
FAQ - Häufig gestellte Fragen zu OpenSearch und Stackable
Wie installiere ich den OpenSearch-Operator auf Kubernetes?
Empfohlen wird die Installation mit stackablectl, dem Command-Line-Tool, das die Stackable-Operatoren und ihre Abhängigkeiten in einem Schritt einrichtet; Helm-Charts stehen ebenfalls bereit. Wichtig ist, die Commons-, Secret- und Listener-Operatoren einzubinden – sie sind erforderlich und stellen gemeinsame Dienste wie Konfigurations-handling, Secret-Management und Service Discovery bereit. Auf OpenShift lässt sich der Operator über den Red Hat Certified Operators Catalog installieren.
Welche OpenSearch-Versionen werden unterstützt?
Der Operator verfolgt die aktuellen OpenSearch-LTS-Releases sowie weitere Upstream-Versionen; die Seite „Supported product versions“ der Stackable-Dokumentation listet stets den aktuellen Stand. Die Version wird über das Image in der OpenSearchCluster-Ressource gewählt, oder ein eigenes Container-Image für einen Custom-Build referenziert. Aktuelle Liste
Lassen sich OpenSearch Dashboards automatisch deployen?
Nein. Der Operator konzentriert sich auf die OpenSearch-Such-Engine. OpenSearch Dashboards – die separate Web-UI zur Visualisierung – müssen eigenständig betrieben werden.
Lassen sich OpenSearch-Nodes nach Rolle skalieren?
Jede Node-Group (zum Beispiel cluster_manager, data, ingest, coordinating_only, search, warm) lässt sich unabhängig skalieren. Das Herunterskalieren erfordert manuelle Schritte, um Shards sicher zu verschieben, bevor Nodes entfernt werden.
Werden Daten beim Verkleinern des Clusters automatisch umverteilt?
Nein. Beim Entfernen von Nodes verschiebt der Operator die darauf liegenden Shards nicht automatisch auf die verbleibenden Nodes. Diese Umverteilung muss vorab manuell angestoßen werden – über die Standard-OpenSearch-Prozeduren, etwa die Cluster-Reroute-API -, bevor der Cluster verkleinert wird.
Wie führe ich OpenSearch-Upgrades durch?
Der Operator unterstützt Rolling Upgrades: Er aktualisiert Node für Node, sodass der Cluster während des gesamten Vorgangs verfügbar bleibt.
Wie ändere ich Memory- und Disk-Einstellungen in OpenSearch?
Memory und CPU: Resource Requests und Limits in der CRD anpassen, woraufhin der Operator die betroffenen Pods neu startet, um die Änderung ohne Downtime zu übernehmen. Disk-Größe: Das Anpassen der Größe in der Konfiguration vergrößert bestehende Persistent Volumes in der Regel nicht (eine Kubernetes-Limitierung) – größere Volumes müssen manuell oder über eine expansionsfähige StorageClass bereitgestellt werden.
Wie wird TLS in OpenSearch eingerichtet?
TLS lässt sich End-to-End aktivieren. Zertifikate werden automatisch generiert und verwaltet, oder man bringt eine eigene CA und eigene Zertifikate mit.
Wird Node-to-Node-Verschlüsselung in OpenSearch unterstützt?
Ja. TLS kann sowohl die Transport-Ebene (Node-to-Node) als auch die Client-Ebene (HTTP) absichern.
Lässt sich die Shard-Allocation in OpenSearch steuern (AZ-/Rack-Awareness)?
Ja – über die Standard-OpenSearch-APIs. Shard-Allocation und Zone-/Rack-Awareness sind Funktionen von OpenSearch selbst, nicht des Operators.
Lassen sich mehrere OpenSearch-Cluster deployen?
Ja. Es lassen sich mehrere OpenSearchCluster-Ressourcen in derselben Kubernetes-Umgebung definieren; der Operator verwaltet jeden Cluster unabhängig.
Unterstützt OpenSearch Prometheus-Monitoring?
Ja. Der Operator stellt Metriken bereit, die von Prometheus gescrapt werden können – so lässt sich OpenSearch einfach in den vorhandenen Kubernetes-Monitoring-Stack integrieren.
Unterstützt der OpenSearch-Operator Vektorsuche und Machine Learning?
Ja. Das Stackable-Image bringt die k-NN- und ML-Plugins mit, sodass sich Vektor- und semantische Suche – die Art von Retrieval, die AI-Use-Cases antreibt – ebenso nutzen lässt wie OpenSearchs ML-Funktionen, ohne selbst Plugins hinzuzufügen.
Welche Kubernetes-Plattformen unterstützt der OpenSearch-Operator?
Der Operator wurde auf den wichtigsten managed und selbst gehosteten Kubernetes-Plattformen getestet: EKS, AKS, GKE, OpenShift, IONOS und K3s. Diese Flexibilität ermöglicht es, OpenSearch zuverlässig über Cloud-Anbieter oder On-Premise-Infrastruktur hinweg zu deployen – bei gleichzeitigem Vorteil von deklarativem Management und Operator-Automatisierung.
Resources - So nutzt man den Stackable Operator für OpenSearch
Getting Started & Installations-Guide
Schritt-für-Schritt-Anleitung zur Installation der benötigten Stackable-Operatoren – Commons, Secret, Listener und OpenSearch selbst. Enthält Voraussetzungen, stackablectl-Befehle und Helm-Optionen, um schnell einen produktionsreifen OpenSearch-Cluster zum Laufen zu bringen.
Ein tiefer Einblick in die OpenSearchCluster Custom Resource Definition: wie sich Cluster in YAML deklarieren, Node-Rollen und Ressourcen konfigurieren und die Reconciliation-Logik des Operators verstehen lassen.
Das offizielle Open-Source-Repository für den Stackable OpenSearch Operator, mit Quellcode, Helm-Charts und Beispielkonfigurationen. Ideal für Entwickler und Betreiber, die Konfigurationen erkunden, beitragen oder Deployments automatisieren möchten.
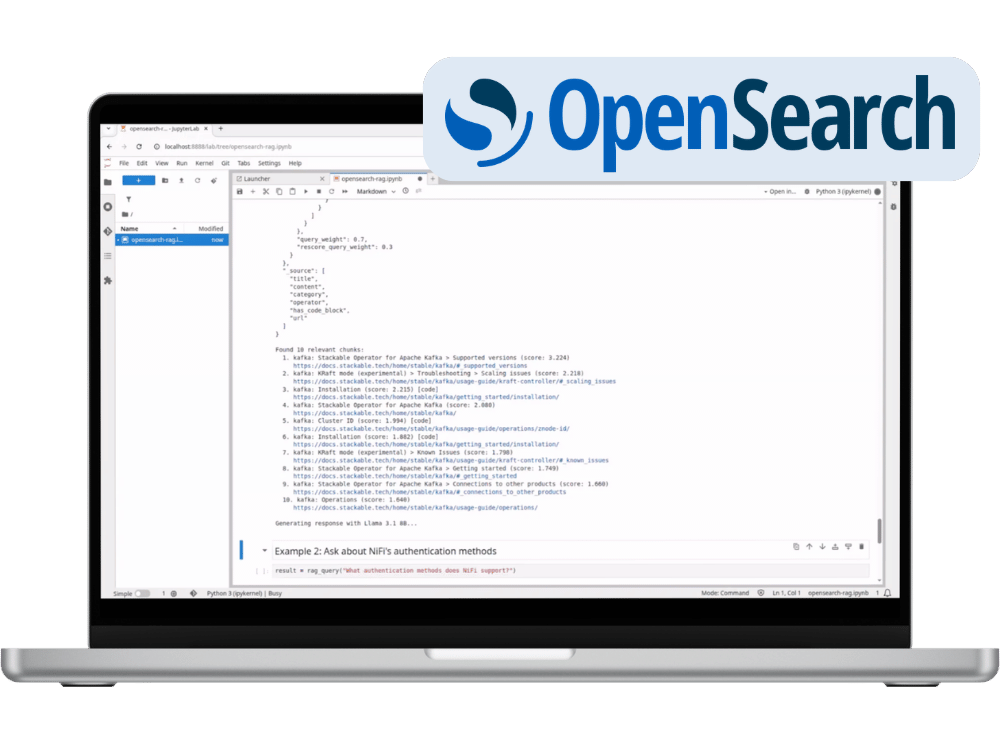
Die opensearch-rag-Demo baut eine RAG-Pipeline auf OpenSearchs Vektorsuche: k-NN-Suche kombiniert mit Keyword-Matching, ein lokal laufendes LLM (über Ollama) und ein JupyterLab-Notebook, das die Pipeline Schritt für Schritt durchgeht – komplett auf Kubernetes, ohne GPU, installierbar mit einem einzigen stackablectl-Befehl.