Stackable
Now available: Stackable Data Platform 26.7 → SLSA provenance, dynamic image repositories & more!
Jetzt verfügbar: Stackable Data Platform 26.7 → SLSA-Provenance, dynamische Image-Repositories & mehr!
Data-Lakehouse-Technologie im Überblick
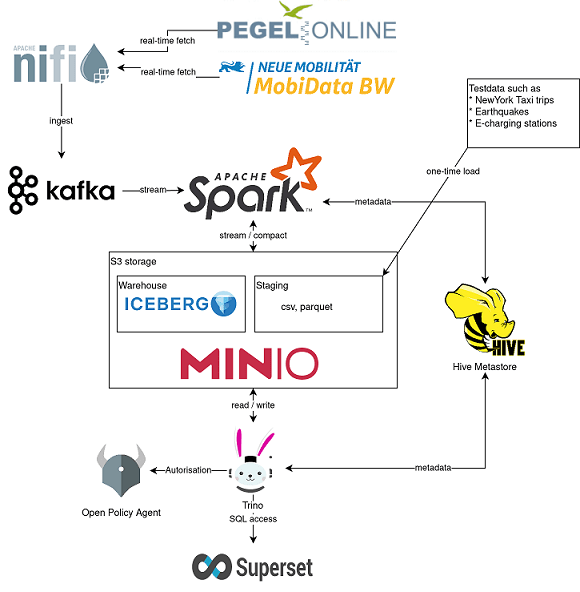
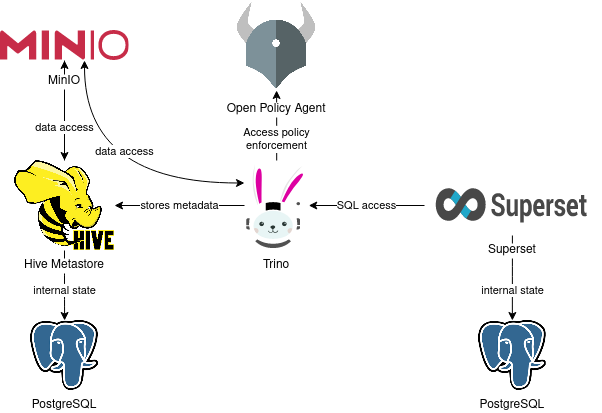
Ein modernes Lakehouse-Blueprint: Apache NiFi streamt Daten in Apache-Iceberg-Tabellen auf S3, Trino fragt sie per SQL ab und Superset macht Dashboards daraus, mit Schema-Evolution und Time Travel.
SO GEHT'S LOS
Mit einem Kubernetes-Cluster genügt ein einziger Befehl:
Funktionen
Offenes Tabellenformat
Apache Iceberg bringt ACID, Schema-Evolution und Time Travel in den Lake.
Warehouse-SQL auf dem Lake
Trino fragt Iceberg direkt ab, ohne Kopien und ohne separates Warehouse.
Schema-Evolution
Spalten hinzufügen oder umbenennen, ohne Daten neu zu schreiben.
Streaming-Ingestion
NiFi lädt kontinuierlich Daten in Iceberg-Tabellen.
Time Travel
Frage jeden historischen Snapshot einer Tabelle ab.
Self-Service-BI
Superset-Dashboards direkt auf Trino aufgesetzt.
Demo-Komponenten
Apache Iceberg
Tabellenformat
Offenes Tabellenformat mit ACID-Transaktionen, Schema-Evolution und Snapshot-Time-Travel.
Apache NiFi
Ingestion
Flow-basierte Ingestion, die Quelldaten in die Iceberg-Tabellen streamt.
Trino
Query-Engine
Verteilte SQL-Engine, die Iceberg-Tabellen mit vollem ANSI-SQL abfragt.
Apache Superset
BI
Dashboards und Exploration auf Basis der Trino-Verbindung.
Demo-Ablauf
Installation
Ein Befehl installiert NiFi, Iceberg-gestützten Speicher, Trino und Superset.
Mit NiFi ingesten
Beobachte, wie NiFi Quelldaten in Iceberg-Tabellen auf S3 streamt.
In Trino abfragen
Führe volles SQL gegen die Iceberg-Tabellen aus, ganz ohne Datenbewegung.
Snapshot per Time Travel
Frage einen früheren Snapshot ab und sieh die Tabelle wie damals.
Dashboard erkunden
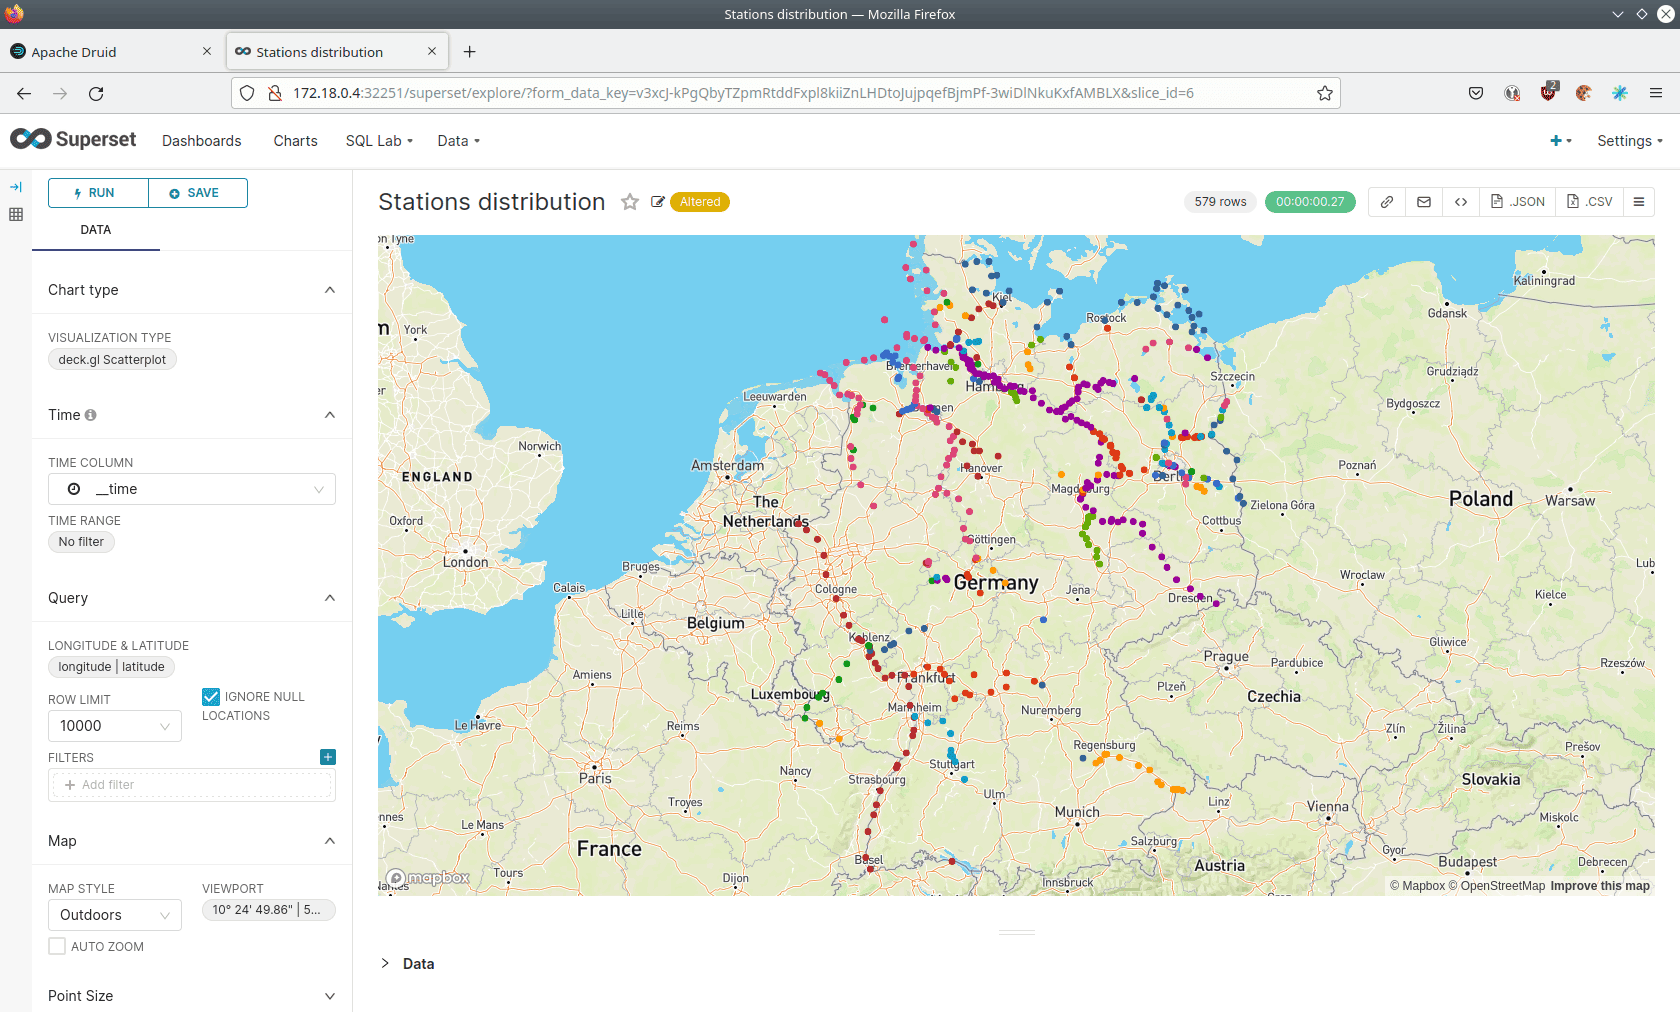
Öffne das vorgefertigte Superset-Dashboard auf dem Lakehouse.
Baue ein Lakehouse, das Streaming-Ingestion mit SQL auf Warehouse-Niveau verbindet.