Stackable
Now available: Managed Data Lakehouse → Sovereign, Compliant, Open Source. Try it free for 30 days.
Jetzt verfügbar: Managed Data Lakehouse → Souverän, Compliant, Open Source. 30 Tage kostenlos testen.
Analyse mit einem Data Lake
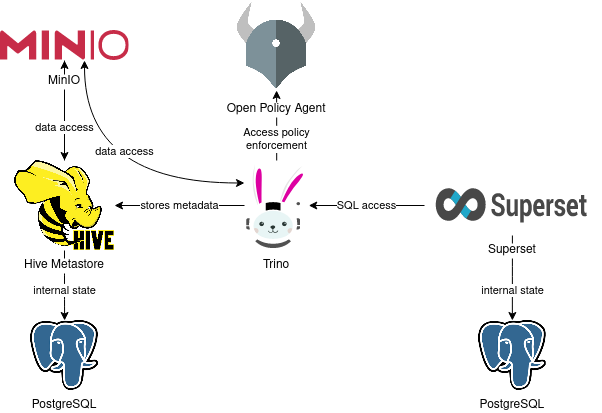
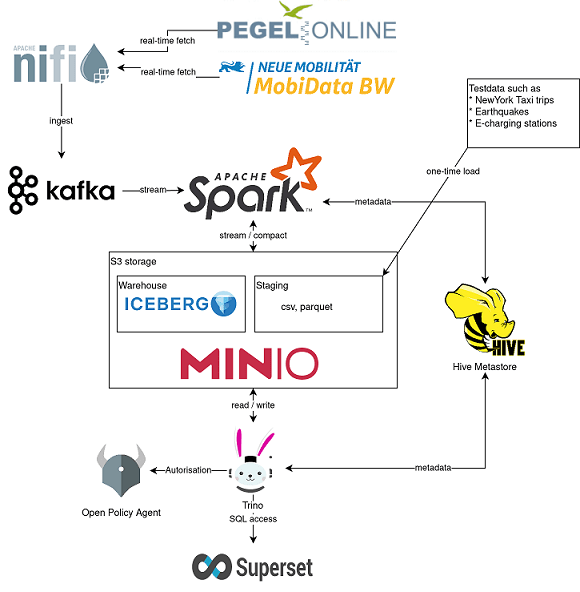
Daten in S3 durchgängig bis zum Dashboard analysiert: Trino fragt Parquet-Dateien direkt über einen Hive-Metastore ab, mit rollenbasiertem Zugriff durch Open Policy Agent, visualisiert in Superset.
SO GEHT'S LOS
Mit einem Kubernetes-Cluster genügt ein einziger Befehl:
Funktionen
Dateien an Ort und Stelle abfragen
Trino liest Parquet auf S3 direkt, ohne Ladeschritt.
Rollenbasierter Zugriff
Open Policy Agent erzwingt, wer was abfragen darf.
BI-fähig
Superset-Dashboards direkt auf Trino aufgesetzt.
Hive-Metastore
Ein Schema-Katalog über den Rohdateien im Lake.
Föderiertes SQL
Verknüpfe mehrere Quellen in einer einzigen Abfrage.
Offene Formate
Parquet auf S3, ohne proprietären Speicher und ohne Lock-in.
Demo-Komponenten
Trino
Query-Engine
Verteilte SQL-Engine, die Parquet-Dateien auf S3 an Ort und Stelle abfragt.
Katalog
Liefert den Schema-Katalog, der SQL-Tabellen auf Dateien abbildet.
MinIO
Speicher
S3-kompatibler Objektspeicher, der den Parquet-Datensatz hält.
Open Policy Agent
Autorisierung
Erzwingt rollenbasierte Zugriffskontrolle über den Trino-Katalog.
Demo-Ablauf
Installation
Ein Befehl installiert Trino, den Hive-Metastore, OPA und MinIO.
Daten katalogisieren
Der Metastore stellt die S3-Parquet-Dateien als SQL-Tabellen bereit.
Mit Trino abfragen
Führe volles SQL gegen die Dateien aus, ohne Daten zu bewegen.
An eine Zugriffsgrenze stoßen
Sieh eine eingeschränkte Abfrage durch die OPA-Regel abgelehnt.
Dashboard erkunden
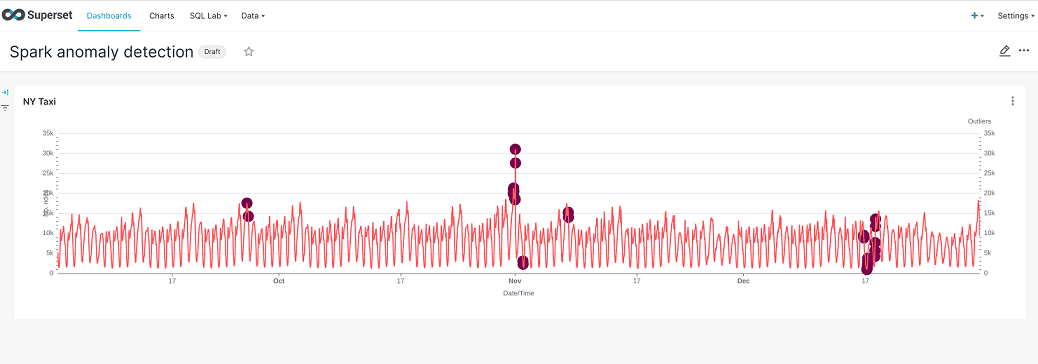
Öffne das Superset-Dashboard auf dem geregelten Katalog.
Frage Dateien im Objektspeicher mit vollem SQL und geregeltem Zugriff ab.