Events warten nicht. Zahlungen, Sensordaten, Klicks, Transaktionen treffen kontinuierlich ein, und etwas muss sie zuverlässig zwischen allen beteiligten Systemen transportieren. Apache Kafka ist genau dieses Rückgrat, und der Stackable Operator automatisiert Deployment, Skalierung und Verwaltung auf Kubernetes, inklusive OPA-basierter Autorisierung, TLS und einheitlichem Monitoring über Prometheus und Grafana. Ob on-prem, air-gapped oder in einer souveränen Cloud – die Daten bleiben in eigener Hand.
Warum Apache Kafka in der Stackable Data Platform (SDP)?
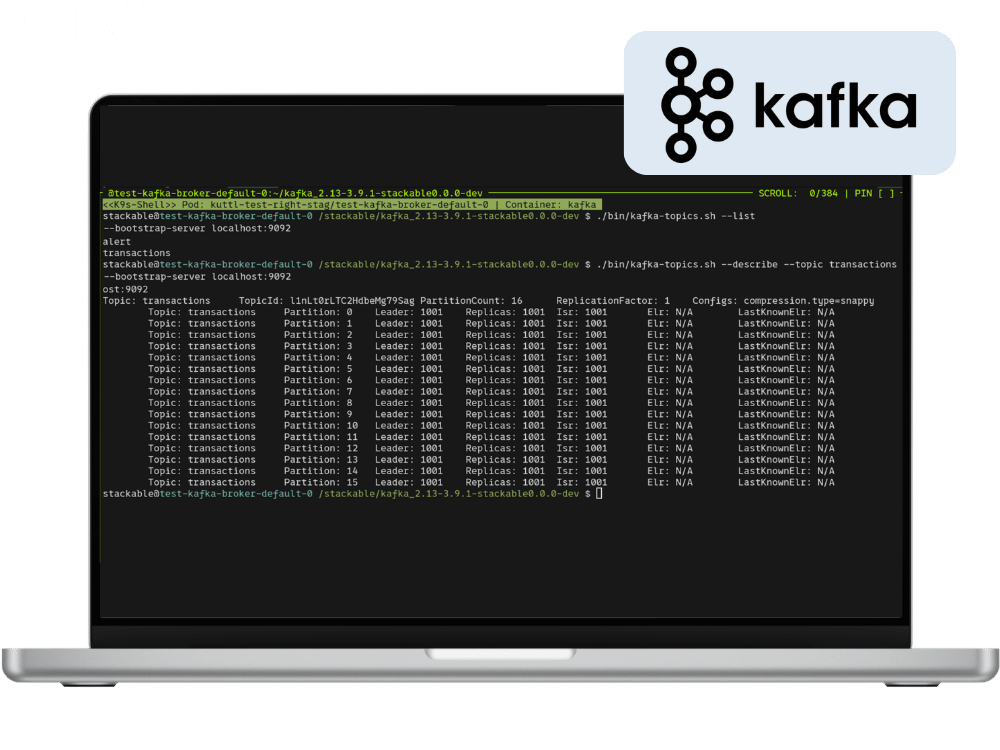
Apache Kafka ist eine verteilte Event-Streaming-Plattform für leistungsstarke Echtzeit-Datenpipelines. Anwendungen veröffentlichen, speichern und konsumieren Datenströme zuverlässig, aus Kafka und in Kafka. In der Stackable Data Platform ist Apache Kafka das Rückgrat ereignisgesteuerter Architekturen und verbindet Producer und Consumer über die gesamte Infrastruktur hinweg, mit Skalierbarkeit, Langlebigkeit und geringer Latenz.
Hoher Durchsatz, geringe Latenz
Millionen von Nachrichten pro Sekunde mit minimaler Verzögerung – ideal für Echtzeitanalysen, Monitoring und ETL.
Skalierbar & ausfallsicher
Horizontal skalieren durch einfaches Hinzufügen von Brokern oder Partitionen; Replikation zwischen Brokern sorgt für Fehlertoleranz und garantierte Zustellung, sodass Streams auch bei Ausfällen zuverlässig bleiben.
Integration der Stream-Verarbeitung
Direktes Zusammenspiel mit Spark und Trino, um Pipelines für Echtzeitverarbeitung und -anreicherung zu bauen.
Sicherheit durch Design
End-to-End-TLS-Verschlüsselung, SASL-Authentifizierung und rollenbasierte Zugriffskontrolle bilden ein sicheres Messaging-Backbone.
Was bringt der Stackable Operator für Apache Kafka mit?
Verbindungen ohne manuelle Konfiguration
Der Operator veröffentlicht eine ConfigMap mit allen Broker-Verbindungsdetails und Listener-Endpunkten. Clients und andere Stackable-Komponenten (Apache NiFi, Apache Spark, Trino) verbinden sich ohne manuelle Konfiguration, bereit für End-to-End-Streaming-Pipelines.
Kafka 3 und Kafka 4 gemeinsam betreiben
Klassische ZooKeeper-basierte Kafka-3-Cluster und Kafka-4-Cluster im KRaft-Modus mit demselben Operator betreiben und KRaft im eigenen Tempo einführen.
Rollenbasierte Broker-Topologien
Broker-Rollen und Role-Groups definieren, um die Konfiguration für unterschiedliche Workloads innerhalb eines einzelnen Clusters anzupassen.
Was haben alle Stackable-Operatoren gemeinsam?
Ein Operator-Framework (Rust)
Jeder Operator folgt demselben CRD-Muster mit Roles, RoleGroups und ConfigOverrides. Wer einen Operator kennt, findet sich sofort im nächsten zurecht.
Infrastructure-as-Code
Jede Data-App ist eine YAML-CRD, die in Git lebt – reviewbar, lintbar und CI/CD-fähig, mit eingebauten Validierungsregeln, die Fehlkonfigurationen früh abfangen. Dieselbe Definition funktioniert auf Dev, Test und Prod.
Lifecycle-Management (Day-2 Operations)
Deployment, Restarts, Zertifikatsrotation und Rolling Upgrades laufen automatisch – inklusive Pod-Restarts, wenn sich Configs oder Secrets ändern. Und weil man sehen muss, was läuft, ist Monitoring & Logging gleich mit dabei: Prometheus, Vector und OpenTelemetry speisen fertige Grafana-Dashboards – ein Observability-Setup für die ganze Plattform.
Security by default:
TLS, Kerberos für HDFS, OIDC-Login und OPA-basierte, feingranulare Autorisierung, alles pro CRD konfigurierbar. Tägliche Vulnerability-Scans, SBOMs und mit cosign signierte Images halten die ganze Plattform gepatcht – man muss nicht selbst ein Dutzend Upstream-Projekte im Blick behalten.
Kubernetes-native und modular
Läuft on-prem, in jeder Cloud oder auf einem Laptop, ohne Vendor-Lock-in – mit explizitem air-gapped Support. Nur die benötigten Operatoren installieren und später weitere hinzufügen, ohne den Rest anzufassen.
OpenShift-zertifiziert
Alle Operatoren sind Red-Hat-zertifiziert und direkt über den Red Hat Certified Operators Catalog (OperatorHub) installierbar – kompatibel mit Security Context Constraints und RBAC. Zertifizierter Betrieb über eine Stackable-Subscription.
Use Cases für Kafka
Ereignisgesteuerte Architekturen
Moderne Anwendungen auf Kafka bauen – von Fraud Detection bis Supply-Chain-Management – mit zuverlässiger, latenzarmer Kommunikation zwischen Microservices. Stackable vereinfacht den Cluster-Betrieb und hält alles hochverfügbar.
Data-Streaming & Integration
Kafka ist das Rückgrat für Pipelines – es sammelt Events aus Apps, Sensoren und Services und verteilt sie an Spark, HBase oder OpenSearch. Mit Stackable lassen sich Cluster für Spitzenlasten einfach skalieren.
IoT- & Edge-Datenaufnahme
Telekommunikation, Automobilindustrie und Energie verlassen sich auf Kafka, um kontinuierliche Streams von IoT-Geräten aufzunehmen. Stackable macht es leicht, robuste Cluster zu betreiben, die Daten sicher vom Edge zu zentralen Plattformen weiterleiten.
FAQ - Häufig gestellte Fragen zu Kafka und Stackable
Welche Kafka-Versionen werden unterstützt?
Die aktuell unterstützten und getesteten Apache-Kafka-Versionen stehen auf der Seite „Supported product versions“ der Stackable-Dokumentation und werden aktuell gehalten, sobald neue Releases validiert und ältere ausgemustert werden. Die Version wird über das Image in der KafkaCluster-Ressource gewählt; eigene Images werden bei Bedarf unterstützt. Aktuelle Liste.
Wie installiere ich den Kafka-Operator auf Kubernetes?
Empfohlen wird stackablectl: Mit `stackablectl operator install kafka` die neueste veröffentlichte Version des Kafka-Operators installieren und anschließend eine KafkaCluster Custom Resource deployen, um den Cluster deklarativ zu erstellen und zu verwalten. Helm wird ebenfalls unterstützt, wenn Deployments über GitOps- oder Helm-Pipelines verwaltet werden. Auf OpenShift lässt sich der Operator über den Red Hat Certified Operators Catalog installieren.
Brauche ich mit Kafka weiterhin ZooKeeper?
Kafka-3-Deployments benötigen ZooKeeper für Cluster-Koordination, Topic-Metadaten und Broker-Management; ZooKeeper lässt sich mit dem Stackable ZooKeeper Operator für einfaches Lifecycle-Management deployen. Kafka-4-Deployments nutzen den integrierten KRaft-Algorithmus zur Cluster-Koordination und benötigen kein Apache ZooKeeper mehr.
Wie funktioniert Service Discovery bei Kafka?
Der Operator generiert automatisch eine ConfigMap, die alle Broker-Verbindungsdetails und Listener-Endpoints enthält. Client-Anwendungen – Producer, Consumer oder andere Stackable-Komponenten (NiFi, Spark, Trino) – können diese ConfigMap referenzieren, um sich nahtlos und ohne manuelle Konfiguration mit dem Kafka-Cluster zu verbinden.
Wie aktiviere ich OPA-basierte Autorisierung für Kafka?
Open Policy Agent (OPA) lässt sich direkt in den Kafka-Cluster integrieren – für feingranulare Zugriffskontrolle. In der KafkaCluster-CRD einen authorization.opa-Abschnitt definieren und eine Policy-ConfigMap mit den Rego-Regeln und dem OPA-Package referenzieren. Das ermöglicht zentrale, auditierbare Autorisierungsrichtlinien im Einklang mit den Sicherheitsstandards der Organisation.
Wie aktiviere ich TLS-Verschlüsselung für Kafka?
TLS lässt sich aktivieren, indem in der KafkaCluster-Ressource ein tls-Abschnitt definiert wird. Der Operator provisioniert und verteilt die benötigten Zertifikate automatisch über alle Broker und Clients und sorgt so für verschlüsselte Kommunikation zwischen Nodes und externen Clients. Zertifikatserneuerung und -rotation sind über das integrierte Zertifikatsmanagement von Stackable vollständig automatisiert.
Lässt sich die Kafka-Konfiguration anpassen?
Ja. Der Operator unterstützt das Überschreiben von Kafka-Konfigurationsparametern direkt über die KafkaCluster-CRD. Log-Level, Broker-Properties oder JVM-Optionen (z. B. log4j-Einstellungen) lassen sich anpassen, um den betrieblichen und Performance-Anforderungen der jeweiligen Umgebung gerecht zu werden.
Welche Kubernetes-Plattformen unterstützt der Kafka-Operator?
Der Operator wurde auf den wichtigsten managed und selbst gehosteten Kubernetes-Plattformen getestet: EKS, AKS, GKE, OpenShift, IONOS und K3s. Diese Flexibilität ermöglicht es, Kafka zuverlässig über Cloud-Anbieter oder On-Premise-Infrastruktur hinweg zu deployen – bei gleichzeitigem Vorteil von deklarativem Management und Operator-Automatisierung.
Resources - So nutzt man den Stackable Operator für Apache Kafka
Getting Started Guide
Schritt-für-Schritt-Anleitung, um den ersten Kafka-Cluster mit dem Stackable Operator zu deployen.
Das offizielle Open-Source-Repository für den Stackable Kafka Operator, mit Quellcode, Helm-Charts und Beispielkonfigurationen. Ideal für Entwickler und Betreiber, die Konfigurationen erkunden, beitragen oder Deployments automatisieren möchten.