Stackable Operator für Apache Superset
Apache Superset™ auf der
Stackable Data Platform
Superset nativ auf Kubernetes betreiben
Self-Service-Analytics ohne Deployment-Ärger
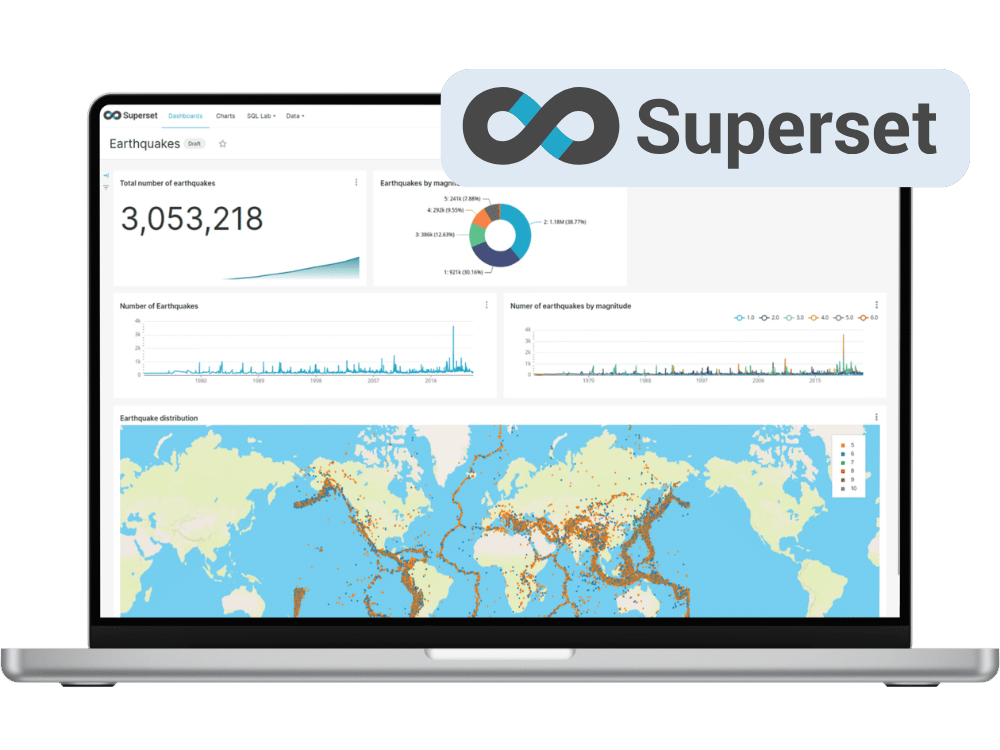
Der Stackable Operator für Apache Superset betreibt Apache Superset Kubernetes-nativ, deklarativ, standardmäßig abgesichert und direkt mit der übrigen Datenplattform verbunden. Teams bekommen Dashboards ohne Wartezeit: Data Analysts erkunden und visualisieren Daten, während Zugriff und Kontrolle vollständig bei der Plattform bleiben. Ob on-prem, air-gapped oder in der souveränen Cloud – die Daten bleiben in eigener Hand.
Warum Superset in der Stackable Data Platform (SDP)?
Apache Superset ist ein leistungsfähiges Werkzeug zum Erkunden und Visualisieren von Daten, gleichermaßen geeignet für Fachanwender, die per Drag-and-drop ein Diagramm zusammenstellen, wie für Data Analysts, die in SQL Lab Abfragen schreiben. Es verbindet sich direkt mit vorhandenen Datenbanken und Query-Engines, sodass Auswertungen dort entstehen, wo die Daten bereits liegen, und nicht in einer weiteren Kopie.
Self-Service-Analytics für alle
Daten per Drag-and-drop oder über eine vollwertige SQL-IDE (SQL Lab) erkunden – für Business-Nutzer und Analysten gleichermaßen.
Keine Lizenzgrenzen pro Nutzer
Superset ist Open Source – ob 10 oder 1.000 Personen darauf zugreifen, macht bei der Lizenzierung keinen Unterschied.
Umfangreiche Visualisierung
40+ Visualisierungstypen standardmäßig – Karten, Diagramme, Tabellen – plus eigene Visualisierungen über Plug-ins.
Interaktive Dashboards & Filterung
Filter, Cross-Filter, Drill-to-Detail und Drill-by machen aus einem statischen Report etwas, das man wirklich erkundet.
Templating & Branding
Jinja-Templates ermöglichen dynamische Queries, CSS-Templates passen Dashboards an das eigene Branding an.
Offen & community-driven
Ein Apache-Projekt, offen entwickelt und durch die Community getragen.
Was bringt der Stackable Operator für Apache Superset mit?
Analytics in Minuten, deklarativ skaliert
Analyseumgebungen in Minuten aufsetzen. Apache Superset horizontal skalieren, indem die Replicas in der CRD angepasst werden, während Webserver und Worker unabhängig voneinander skalieren. So bekommen interaktive Dashboards und Hintergrundjobs wie geplante Reports und Alerts jeweils die Kapazität, die sie brauchen.“

Zentrale Datenquellen, einheitliche Dashboards
Datenquellen-Verbindungen zentral als deklarative Kubernetes-Ressourcen verwalten. Trino für interaktives SQL und OpenSearch für Log- und Event-Analytics anbinden und mehrere Quellen in einheitlichen Dashboards zusammenführen.

Feingranulares RBAC für Multi-Team-Nutzung
Zugriff per rollenbasierter Zugriffskontrolle steuern, bis auf einzelne Dashboards und Datasets. Rollen werden auf Nutzer oder Gruppen gemappt und als versionierbare Konfiguration verwaltet, was den Betrieb durch mehrere Teams mit klaren Sicherheitsgrenzen praktikabel macht.
Was haben alle Stackable-Operatoren gemeinsam?
Ein Operator-Framework (Rust)
Jeder Operator folgt demselben CRD-Muster mit Roles, RoleGroups und ConfigOverrides. Wer einen Operator kennt, findet sich sofort im nächsten zurecht.
Infrastructure-as-Code
Jede Data-App ist eine YAML-CRD, die in Git lebt – reviewbar, lintbar und CI/CD-fähig, mit eingebauten Validierungsregeln, die Fehlkonfigurationen früh abfangen. Dieselbe Definition funktioniert auf Dev, Test und Prod.
Lifecycle-Management (Day-2 Operations)
Deployment, Restarts, Zertifikatsrotation und Rolling Upgrades laufen automatisch – inklusive Pod-Restarts, wenn sich Configs oder Secrets ändern. Und weil man sehen muss, was läuft, ist Monitoring & Logging gleich mit dabei: Prometheus, Vector und OpenTelemetry speisen fertige Grafana-Dashboards – ein Observability-Setup für die ganze Plattform.
Security by default:
TLS, Kerberos für HDFS, OIDC-Login und OPA-basierte, feingranulare Autorisierung, alles pro CRD konfigurierbar. Tägliche Vulnerability-Scans, SBOMs und mit cosign signierte Images halten die ganze Plattform gepatcht – man muss nicht selbst ein Dutzend Upstream-Projekte im Blick behalten.
Kubernetes-native und modular
Läuft on-prem, in jeder Cloud oder auf einem Laptop, ohne Vendor-Lock-in – mit explizitem air-gapped Support. Nur die benötigten Operatoren installieren und später weitere hinzufügen, ohne den Rest anzufassen.
OpenShift-zertifiziert
Alle Operatoren sind Red-Hat-zertifiziert und direkt über den Red Hat Certified Operators Catalog (OperatorHub) installierbar – kompatibel mit Security Context Constraints und RBAC. Zertifizierter Betrieb über eine Stackable-Subscription.
Use Cases für Superset
Operative Echtzeit-Dashboards
Angeschlossen an Streaming-Daten (z. B. über Kafka und Trino) visualisiert Superset Ereignisse in Echtzeit – von Zahlungsströmen bis hin zu IoT-Flotten – und ermöglicht so eine sofortige Reaktion, statt erst am nächsten Morgen zu reagieren.
Self-Service-BI im ganzen Unternehmen
Fachbereiche erkunden Daten ohne SQL, mit Drag-and-drop-Diagrammen und Filtern. Der Kubernetes-Operator hält die Plattform hochverfügbar und skaliert reibungslos, wenn weitere Teams hinzukommen.
Die Visualisierungsschicht der Datenplattform
Superset macht Daten sichtbar – Apache HBase für historische Daten, Trino für schnelle Abfragen, OpenSearch für Logs – und macht aus Rohdaten sichtbare Analysen. An einem Ort laufen die Daten aus all diesen Systemen zusammen und werden für Analytics nutzbar.
FAQ - Häufig gestellte Fragen zu Superset und Stackable
Der Operator unterstützt die Apache-Superset-Versionen, die auf der Seite „Supported product versions“ der Stackable-Dokumentation gelistet sind. Mit jedem Release kommen neue Versionen hinzu, ältere werden mit der Zeit abgekündigt – der aktuelle Stand steht in der Doku. Die Version wird über das Image in der SupersetCluster-Ressource gewählt; auch eine eigene Registry oder eigene Images sind möglich.
Aktuelle Liste.
Superset verbindet sich über SQLAlchemy mit SQL-Datenbanken und Query-Engines. Das Stackable-Image bringt Treiber für gängige Backends wie Trino, OpenSearch, PostgreSQL und MySQL bereits mit; weitere lassen sich per Treiber-Installation und URI ergänzen. In der SDP zeigen diese Verbindungen in der Regel auf Cluster, die parallel als Stackable-Operatoren laufen – Trino etwa wird als Database Connection in Superset konfiguriert, die auf den plattformintern laufenden Trino-Cluster zeigt. Authentifizierung und TLS laufen über das Secret-Management der Plattform.
Superset lässt sich horizontal skalieren, indem die Anzahl der Replicas in der Kubernetes Custom Resource Definition (CRD) angepasst wird. Der Operator übernimmt Rolling Updates und den Pod-Lifecycle.
Der Stackable Operator regelt Authentifizierung deklarativ über eine AuthenticationClass: LDAP oder einen OIDC-Provider (z. B. Keycloak) einmal als AuthenticationClass definieren und in der SupersetCluster-CRD referenzieren. Per OIDC angemeldete Nutzer erhalten eine über userRegistrationRole festgelegte Standardrolle. Da dieselbe AuthenticationClass auch von anderen SDP-Komponenten (Trino, Airflow, NiFi …) genutzt wird, wird SSO einmal zentral konfiguriert statt pro Produkt. Supersets eingebaute Datenbank-Authentifizierung bleibt als einfacher Einstieg verfügbar; für den Produktivbetrieb ist OIDC der empfohlene Weg.
Ja. Superset unterstützt feingranulare rollenbasierte Zugriffskontrolle (RBAC). Berechtigungen werden Rollen zugewiesen, die dann auf Nutzer oder Gruppen gemappt werden. Mit dem Stackable Operator lassen sich diese Richtlinien deklarativ und versioniert verwalten, was das Durchsetzen von Sicherheitsgrenzen über mehrere Teams hinweg erleichtert.
Ja. Der Stackable Operator stellt Metriken bereit, die sich nahtlos in Prometheus und Grafana einfügen. Dazu gehören Anwendungsmetriken (z. B. Query-Latenz, Request-Zahlen) ebenso wie Metriken auf Container-Ebene. Dashboards für Superset-Health und -Nutzung lassen sich in Grafana importieren.
Ja. Für abgeschottete Umgebungen lassen sich die benötigten Container-Images und Abhängigkeiten in eine private Registry spiegeln, deren Konfiguration der Stackable Operator unterstützt. Beachte dabei, dass für das Beschaffen und Aktualisieren der Python-Abhängigkeiten der Connectoren zusätzlicher Aufwand anfällt.
Ja. Innerhalb einer Instanz unterstützt Superset mehrere Teams über rollenbasierte Trennung und separate Workspaces. Eine strikte Mandantentrennung ist das nicht (alles läuft in derselben Instanz), aber RBAC und Schema-Trennung in der Backend-Datenbank machen die Nutzung durch mehrere Teams praktikabel. Ist eine härtere Isolation gefragt, lassen sich mit der Stackable Data Platform ebenso einfach mehrere separate Superset-Instanzen betreiben – jede deklarativ als eigener SupersetCluster.
Ja. Superset unterstützt UI-Anpassung und Theming – Farben, Logos, CSS – für das eigene Umfeld. Um solche Anpassungen in Produktion zu übernehmen, wird ein eigenes Docker-Image mit den angepassten Assets gebaut und über eine CI/CD-Pipeline ausgerollt; der Stackable Operator deployt dieses Image anschließend.
Ja. Superset enthält ein Alerts-&-Reports-System. Queries oder Dashboards lassen sich zeitgesteuert ausführen und die Ergebnisse per E-Mail oder Slack zustellen. Für Enterprise-Setups bietet sich die Integration mit Airflow an, um Refresh- und Reporting-Workflows zu orchestrieren.
Superset kann Dashboards, Diagramme und Datasets exportieren und importieren, allerdings ohne dass alle Objektbeziehungen vollständig erhalten bleiben. Der robustere Weg ist ein Dump des Metadaten-Stores (z. B. PostgreSQL), der Dashboards, Diagramme, Datasets und ihre Beziehungen intakt hält.
Der Operator wurde auf den wichtigsten managed und selbst gehosteten Kubernetes-Plattformen getestet: EKS, AKS, GKE, OpenShift, IONOS und K3s. Diese Flexibilität ermöglicht es, Superset zuverlässig über Cloud-Anbieter oder On-Premise-Infrastruktur hinweg zu deployen – bei gleichzeitigem Vorteil von deklarativem Management und Operator-Automatisierung.
Resources - So nutzt man den Stackable Operator für Superset
Operator Dokumentation
Diese Dokumentation liefert detaillierte Anleitungen zum Deployen und Verwalten von Superset-Clustern auf Kubernetes mit dem Stackable Operator. Sie deckt Installation, Konfiguration und Integration mit anderen Stackable-Komponenten wie Trino und OpenSearch ab – ideal für den Aufbau einer skalierbaren, sicheren BI-Umgebung.
Integrations-Guides
Diese Guides zeigen, wie sich Superset mit Datenquellen wie Trino für SQL-Abfragen oder OpenSearch für Log-Analytics verbinden lässt. Sie enthalten Schritt-für-Schritt-Anleitungen und Beispiele für den Aufbau einheitlicher Dashboards und ermöglichen nahtlose Multi-Source-Analytics.
GitHub Repository
Das offizielle Open-Source-Repository für den Stackable Superset Operator, mit Quellcode, Helm-Charts und Beispielkonfigurationen. Ideal für Entwickler und Betreiber, die Konfigurationen erkunden, beitragen oder Deployments automatisieren möchten.
Demo
Die Demo trino-taxi-data lädt Taxidaten nach S3, macht sie über Trino per SQL abfragbar und visualisiert sie in Superset-Dashboards – installierbar mit einem einzigen stackablectl-Befehl.
Zum Newsletter anmelden
Newsletter
Zum Newsletter anmelden
Mit dem Stackable Newsletter bist Du immer auf dem Laufenden, wenn es um Updates rund um Stackable geht!