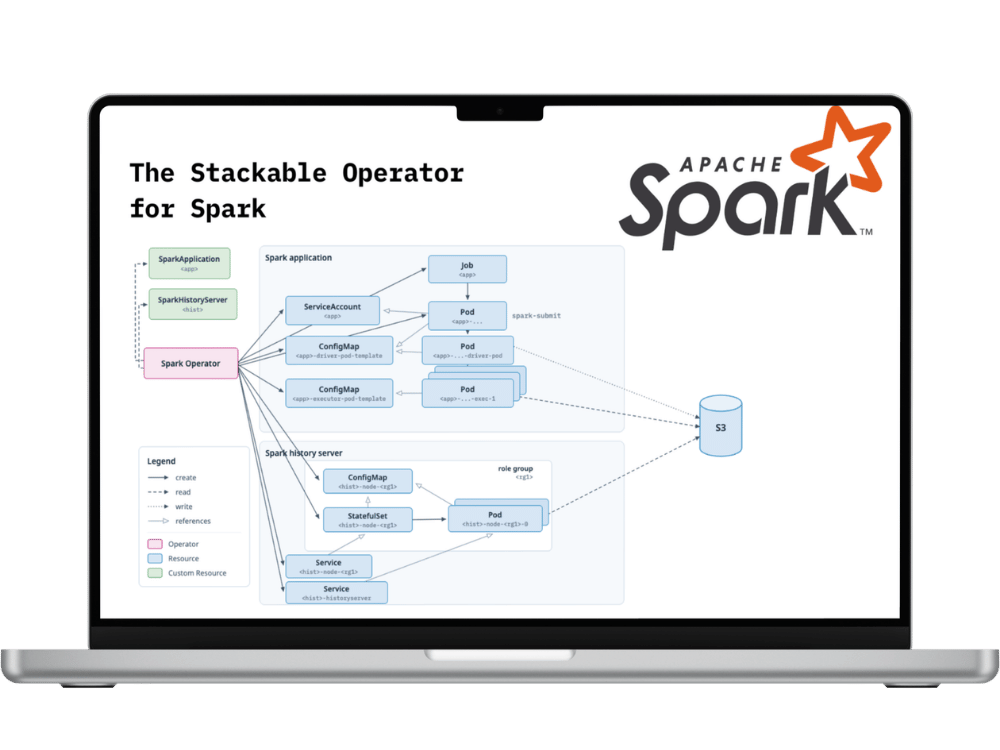
Ein Spark-Job ist schnell geschrieben und überraschend schwer im Produktivbetrieb zuverlässig zu betreiben. Der Stackable Operator übersetzt den als SparkApplication-CRD eingereichten Job in die passenden Kubernetes-Objekte, Driver, Executors, Ressourcen, Logging, und erlaubt das Ergänzen von Abhängigkeiten und Images. Vom einfachen Batch-Job bis zu Streaming- und ML-Workloads, es funktioniert einfach. Ob on-prem, air-gapped oder in einer souveränen Cloud – ohne Vendor-Lock-in.
Warum Apache Spark in der Stackable Data Platform (SDP)
Apache Spark ist eine leistungsfähige Open-Source-Analytics-Engine für die Verarbeitung großer Datenmengen. Mit APIs in Java, Scala, Python und R bewältigt es sowohl Batch- als auch Echtzeit-Workloads. In Verbindung mit Trino, S3 und Apache Airflow lässt sich Apache Spark orchestrieren, um aus riesigen Datenmengen die Features, Modelle und Erkenntnisse zu gewinnen, die Analytics und KI ermöglichen.
Einheitliche Datenverarbeitung & Analytics
Batch, Echtzeit-Streaming und integrierte Bibliotheken für SQL, Machine Learning (MLlib) und Graph-Processing (GraphX) in einem einzigen Framework – unterschiedlichste Workflows und umfassende Analysen an einem Ort.
Unterstützung mehrerer Sprachen
Entwickler und Data Scientists können in Java, Scala, Python oder R direkt einsteigen – mit APIs, die ihre Sprache sprechen.
Skalierbarkeit & Fehlertoleranz
In-Memory-Processing und eine fehlertolerante Architektur bewältigen die Verarbeitung großer Datenmengen effizient und zuverlässig.
Höhere Entwicklerproduktivität
Spark Connect ermöglicht es, Clients in Python, Go, .NET und Rust zu bauen – für flexible, entkoppelte Entwicklung.
Was bringt der Stackable Operator für Apache Spark mit?
Abhängigkeiten und Versionen pro Job
Jeder Job ist eine SparkApplication mit eigenem Image und eigenen Abhängigkeiten (Volumes, Maven oder pip). So laufen verschiedene Spark-Versionen in einem Cluster parallel, ideal zum Testen, für schrittweise Migration oder für Teams mit unterschiedlichen Anforderungen.
Spark Connect, bereitgestellt vom Operator
Der Operator stellt Spark-Connect-Server bereit. Entwickler verbinden aus Python, Go, .NET, Rust und ihren eigenen IDEs, ohne Spark lokal zu installieren.
Abgeschlossene Jobs mit dem History Server debuggen
Ein konfigurierbarer Spark History Server liest Event-Logs aus S3 und stellt Ausführungsmetriken, Stage-Timings und Debugging-Details für abgeschlossene Anwendungen bereit.
Was haben alle Stackable-Operatoren gemeinsam?
Ein Operator-Framework (Rust)
Jeder Operator folgt demselben CRD-Muster mit Roles, RoleGroups und ConfigOverrides. Wer einen Operator kennt, findet sich sofort im nächsten zurecht.
Infrastructure-as-Code
Jede Data-App ist eine YAML-CRD, die in Git lebt – reviewbar, lintbar und CI/CD-fähig, mit eingebauten Validierungsregeln, die Fehlkonfigurationen früh abfangen. Dieselbe Definition funktioniert auf Dev, Test und Prod.
Lifecycle-Management (Day-2 Operations)
Deployment, Restarts, Zertifikatsrotation und Rolling Upgrades laufen automatisch – inklusive Pod-Restarts, wenn sich Configs oder Secrets ändern. Und weil man sehen muss, was läuft, ist Monitoring & Logging gleich mit dabei: Prometheus, Vector und OpenTelemetry speisen fertige Grafana-Dashboards – ein Observability-Setup für die ganze Plattform.
Security by default:
TLS, Kerberos für HDFS, OIDC-Login und OPA-basierte, feingranulare Autorisierung, alles pro CRD konfigurierbar. Tägliche Vulnerability-Scans, SBOMs und mit cosign signierte Images halten die ganze Plattform gepatcht – man muss nicht selbst ein Dutzend Upstream-Projekte im Blick behalten.
Kubernetes-native und modular
Läuft on-prem, in jeder Cloud oder auf einem Laptop, ohne Vendor-Lock-in – mit explizitem air-gapped Support. Nur die benötigten Operatoren installieren und später weitere hinzufügen, ohne den Rest anzufassen.
OpenShift-zertifiziert
Alle Operatoren sind Red-Hat-zertifiziert und direkt über den Red Hat Certified Operators Catalog (OperatorHub) installierbar – kompatibel mit Security Context Constraints und RBAC. Zertifizierter Betrieb über eine Stackable-Subscription.
Use Cases für Spark
Datenverarbeitung & ETL
Daten aus vielen Quellen transformieren, bereinigen und aufbereiten. Mit Stackable laufen Spark-Jobs zuverlässig – für schnellere Pipelines und geringere Betriebskosten.
Machine Learning & KI
Mit Spark MLlib und gängigen Frameworks lassen sich Modelle auf großen Datenmengen trainieren und deployen. Der Operator verwaltet Ressourcen dynamisch und unterstützt sowohl Experimentier- als auch Produktiv-Workloads.
Echtzeit-Stream-Processing
In Kombination mit Apache Kafka treibt Spark Streaming Echtzeitanalysen an – von Fraud Detection über IoT-Monitoring bis zur Analyse von Kundenverhalten – auf Clustern, die stabil bleiben und mit eingehenden Streams mitskalieren.
FAQ - Häufig gestellte Fragen zu Spark und Stackable
Wie installiere ich den Spark-Operator auf Kubernetes?
Empfohlen wird stackablectl, das Deployment, Konfiguration und Dependency-Management automatisch übernimmt. Helm-Charts werden ebenfalls unterstützt, wenn Standard-Kubernetes-Tooling bevorzugt wird. Auf OpenShift lässt sich der Operator über den Red Hat Certified Operators Catalog installieren.
Wie reiche ich meinen ersten Spark-Job ein?
Zunächst dem Getting-Started-Guide in der Operator-Dokumentation folgen. Eine SparkApplication-CRD anlegen, die das Container-Image, die Hauptanwendungsdatei, die Executor- und Driver-Ressourcen sowie alle nötigen Umgebungsvariablen angibt, und sie dann mit kubectl apply anwenden. Der Operator stellt automatisch alle benötigten Kubernetes-Ressourcen bereit, plant den Job und verwaltet seinen Lifecycle, inklusive Log-Sammlung und Event-Tracking.
Welche Spark-Versionen werden unterstützt?
Die unterstützten Apache-Spark-Versionen stehen in der Stackable-Dokumentation. Eine passende Version wählen, die zu einem kompatiblen Spark-Image für das Deployment passt, oder ein eigenes Image aus einer eigenen Registry mitbringen – für gepatchte Versionen oder zusätzliche Bibliotheken. Der Operator betreibt mehrere Versionen parallel, sodass sich neue Releases im eigenen Tempo einführen lassen. Aktuelle Liste.
Lassen sich verschiedene Spark-Versionen parallel betreiben?
Ja, indem für jede SparkApplication ein anderes Container-Image angegeben wird. Jede Anwendung läuft unabhängig, sodass mehrere Spark-Versionen konfliktfrei im selben Kubernetes-Cluster koexistieren. Das ist nützlich, um neue Versionen zu testen, Workloads schrittweise zu migrieren oder Teams mit unterschiedlichen Dependency-Anforderungen zu unterstützen.
Wie füge ich einem Spark-Job Abhängigkeiten hinzu?
Abhängigkeiten lassen sich auf mehrere Arten hinzufügen: Custom Container Images, die Bibliotheken oder Pakete enthalten; gemountete Volumes mit JARs oder Konfigurationsdateien; Maven-Koordinaten für Java-/Scala-Bibliotheken (Iceberg, Hadoop-Connectoren usw.); und Python-Pakete über pip für PySpark-Jobs. Die Operator-Dokumentation liefert Beispiele für jede Methode und stellt Reproduzierbarkeit und Versionskontrolle der Abhängigkeiten sicher.
Wohin gehen die Spark-Logs?
Jeder Driver- und Executor-Pod enthält einen Vector-Sidecar, der Logs in einem strukturierten, zentralisierten Format sammelt. Logs lassen sich zusätzlich zur Langzeitspeicherung nach S3 schreiben. Der Spark History Server kann Event-Logs aus S3 lesen, sodass sich abgeschlossene Anwendungen durchsehen, Metriken einsehen und vergangene Läufe leicht debuggen lassen – das sorgt für operative Transparenz und vereinfacht Monitoring und Troubleshooting.
Kann ich mit Spark Daten aus S3/MinIO lesen und schreiben?
Ja. S3 lässt sich über die CRD als Datenquelle konfigurieren, wobei Credentials über Secrets und SecretClasses angegeben werden. Spark kann direkt aus diesen Object Stores lesen und in sie schreiben – das ermöglicht die Integration mit Data Lakes und cloud-nativen Storage-Systemen ohne zusätzliche ETL-Schichten.
Wird Security (z. B. Kerberos für HDFS) in Spark unterstützt?
Ja. Die Operator-Dokumentation liefert Anleitungen zum Konfigurieren der Kerberos-Authentifizierung für HDFS-Zugriff. Der Secret Operator von Stackable kann Keytabs generieren und Credentials sicher verwalten. TLS- und RBAC-Konfigurationen stellen sicher, dass Workloads sicher in Multi-Tenant-Clustern laufen.
Integriert sich der Spark-Operator mit anderen Stackable-Tools?
Ja. Spark lässt sich mit anderen Stackable-Operatoren zu End-to-End-Workflows kombinieren: Spark-Jobs aus Airflow für orchestrierte ETL-Pipelines auslösen, Lakehouse-Tabellen nach Spark-Transformationen mit Trino abfragen und aggregierte Ergebnisse mit Superset visualisieren. Integrationsmuster sind in den Stackable-Plattform-Guides dokumentiert – für zuverlässige, skalierbare und wartbare Analytics-Pipelines.
Lassen sich Spark-Ressourcen tunen?
Ja. Resource Requests und Limits lassen sich pro Rolle definieren, etwa für Driver- oder Executor-Pods, und sogar pro Role-Group. So lässt sich die Zuteilung von CPU, Memory und Storage für jeden Workload-Typ optimieren – hohe Auslastung ohne Over-Provisioning. Das Ressourcen-Tuning hilft außerdem, die Cluster-Stabilität bei gemischten Workloads und hoher Last zu wahren.
Welche Kubernetes-Plattformen unterstützt der Spark-Operator?
Der Operator wurde auf den wichtigsten managed und selbst gehosteten Kubernetes-Plattformen getestet: EKS, AKS, GKE, OpenShift, IONOS und K3s. Diese Flexibilität ermöglicht es, Spark zuverlässig über Cloud-Anbieter oder On-Premise-Infrastruktur hinweg zu deployen – bei gleichzeitigem Vorteil von deklarativem Management und Operator-Automatisierung.
Resources - So nutzt man den Stackable Operator für Apache Spark
Getting Started & Installation
Den Spark-Operator mit stackablectl, Helm-Charts oder dem OpenShift-Katalog installieren, dann den ersten Spark-Job auf Kubernetes einreichen – ein Schritt-für-Schritt-Weg vom Setup bis zum ersten Lauf.
Überblick über den Stackable Operator für Apache Spark, einschließlich unterstützter Funktionen, CRDs und Konfigurationsoptionen für den Betrieb von Spark auf Kubernetes.
Das offizielle Open-Source-Repository für den Stackable Spark Operator, mit Quellcode, Helm-Charts und Beispielkonfigurationen. Ideal für Entwickler und Betreiber, die Konfigurationen erkunden, beitragen oder Deployments automatisieren möchten.
Die spark-k8s-anomaly-detection-taxi-data-Demo trainiert mit Spark ein Anomalie-Erkennungsmodell auf New Yorker Taxidaten aus S3 und schreibt die Ergebnisse in eine Trino-Tabelle. Die Demo ist mit einem einzigen stackablectl-Befehl installierbar.