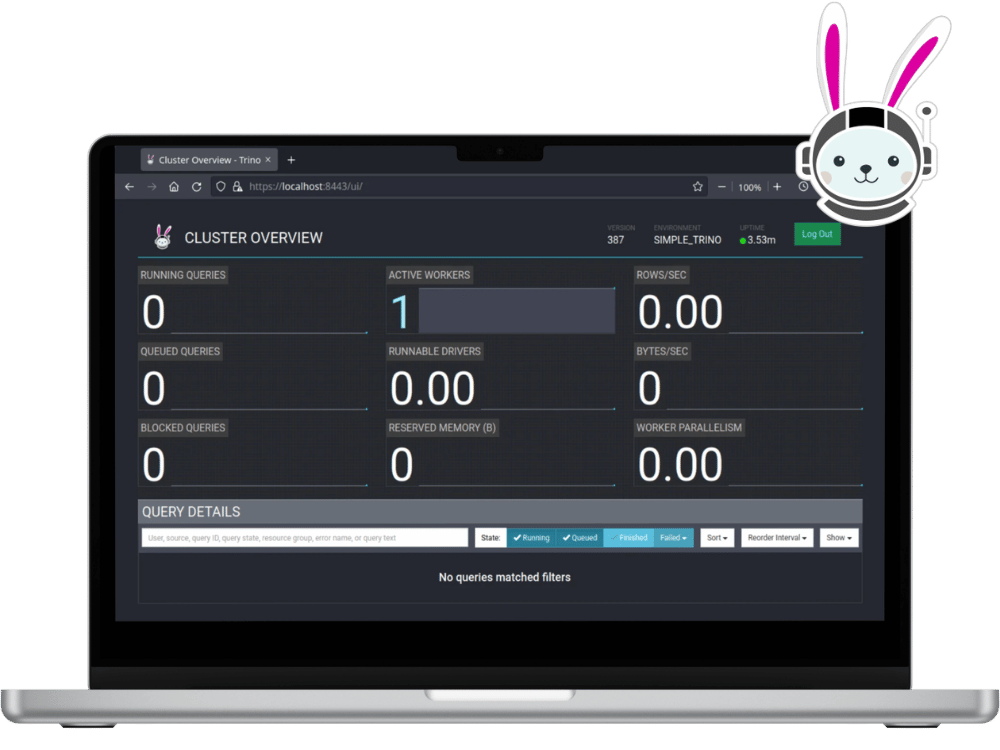
Trino führt verteilte SQL-Abfragen über Daten hinweg aus, die über die verschiedensten Systeme verstreut sind – HDFS, S3, PostgreSQL, operative Systeme, die nie für eine gemeinsame Abfrage gedacht waren – und beantwortet alles mit einer einzigen Abfrage, ohne zwingend Daten zu verschieben oder zu kopieren. Der Stackable Operator betreibt Trino-Cluster und -Kataloge deklarativ auf Kubernetes, mit Authentifizierung, Autorisierung und Data-Federation von Haus aus. Ob on-prem, air-gapped oder in der souveränen Cloud – ohne Vendor-Lock-in, die Daten bleiben in eigener Hand.
Warum Trino in der Stackable Data Platform (SDP)?
Trino ist eine leistungsstarke, verteilte SQL-Query-Engine für interaktive Analysen und Batch-Analytics. Auf Geschwindigkeit und Flexibilität ausgelegt, fragt sie den gesamten Datenbestand ab – mit oder ohne Verschieben oder Duplizieren von Daten.
Geschwindigkeit
Für Analytics mit geringer Latenz gebaut – von Ad-hoc-Abfragen im Sub-Sekunden-Bereich bis zu Batch-Workloads mit hohem Volumen, auch bei komplexen Abfragen.
Enterprise-erprobt
Trino bewältigt unternehmenskritische Workloads bis in den Exabyte-Bereich – von Financial Reporting bis zum Abfragen großer Data Lakes.
Query-Federation
Daten aus mehreren Systemen in einer einzigen Abfrage zusammenführen – etwa S3-Object-Storage mit einer PostgreSQL- oder MySQL-Datenbank kombinieren.
In-Place-Analyse
Daten nativ in Hadoop, S3, Cassandra, MySQL und mehr abfragen, ohne langsames, fehleranfälliges Kopieren.
Einfachheit
ANSI-SQL-konform und über Standard-JDBC/ODBC-Treiber in BI- und Analytics-Tools wie Tableau, R und Apache Superset integrierbar.
Offen & community-driven
Ein von der Community getragenes Projekt unter der Trino Software Foundation.
Was bringt der Stackable Operator für Trino mit?
Kataloge deklarativ verwalten und föderieren
Cluster und Kataloge als CRDs verwalten, wobei jede Datenquelle ein versionierbarer TrinoCatalog ist. Abfragen über Hadoop, S3, PostgreSQL und mehr föderieren, ohne Daten zu verschieben. Lang laufende Abfragen erholen sich automatisch nach Worker-Ausfällen.
Feingranulare Daten-Autorisierung
OPA-basierte Row-Level-Security und Column-Masking, wodurch unterschiedliche Nutzer nur die Zeilen und Spalten sehen, für die sie berechtigt sind. Analysten, BI-Tools und KI-Agenten arbeiten alle auf einer einzigen, kontrollierten Datenbasis.
Add-on: BI-Tools per ODBC verbinden
Ein von Stackable in Rust entwickelter ODBC-Treiber verbindet Power BI, Excel, Tableau und Python mit Trino. Im DirectQuery-Modus werden Filter und Joins aus Power BI direkt an Trino übergeben.
Was haben alle Stackable-Operatoren gemeinsam?
Ein Operator-Framework (Rust)
Jeder Operator folgt demselben CRD-Muster mit Roles, RoleGroups und ConfigOverrides. Wer einen Operator kennt, findet sich sofort im nächsten zurecht.
Infrastructure-as-Code
Jede Data-App ist eine YAML-CRD, die in Git lebt – reviewbar, lintbar und CI/CD-fähig, mit eingebauten Validierungsregeln, die Fehlkonfigurationen früh abfangen. Dieselbe Definition funktioniert auf Dev, Test und Prod.
Lifecycle-Management (Day-2 Operations)
Deployment, Restarts, Zertifikatsrotation und Rolling Upgrades laufen automatisch – inklusive Pod-Restarts, wenn sich Configs oder Secrets ändern. Und weil man sehen muss, was läuft, ist Monitoring & Logging gleich mit dabei: Prometheus, Vector und OpenTelemetry speisen fertige Grafana-Dashboards – ein Observability-Setup für die ganze Plattform.
Security by default:
TLS, Kerberos für HDFS, OIDC-Login und OPA-basierte, feingranulare Autorisierung, alles pro CRD konfigurierbar. Tägliche Vulnerability-Scans, SBOMs und mit cosign signierte Images halten die ganze Plattform gepatcht – man muss nicht selbst ein Dutzend Upstream-Projekte im Blick behalten.
Kubernetes-native und modular
Läuft on-prem, in jeder Cloud oder auf einem Laptop, ohne Vendor-Lock-in – mit explizitem air-gapped Support. Nur die benötigten Operatoren installieren und später weitere hinzufügen, ohne den Rest anzufassen.
OpenShift-zertifiziert
Alle Operatoren sind Red-Hat-zertifiziert und direkt über den Red Hat Certified Operators Catalog (OperatorHub) installierbar – kompatibel mit Security Context Constraints und RBAC. Zertifizierter Betrieb über eine Stackable-Subscription.
Use Cases für Trino
Föderierte Abfragen über Quellen hinweg
Daten, die über HBase, Kafka, Object Stores und relationale Datenbanken verteilt sind, über eine einzige SQL-Schnittstelle verbinden und abfragen – eine Abfrage statt separater Exporte aus jedem System, die man anschließend zusammenführt.
Interaktive Analytics & Dashboards
Trino ist die Basis für Ad-hoc-Analysen und BI. In Verbindung mit Tools wie Superset ermöglicht es die schnelle, interaktive Erkundung riesiger Datasets und liefert Entscheidern Antworten genau dann, wenn sie gebraucht werden.
Data-Lakehouse-Architekturen
Trino wird zur Query-Schicht auf dem Data Lake, mit nativen Katalogen für offene Tabellenformate wie Apache Iceberg und Delta Lake – und macht große Mengen an Rohdaten direkt per SQL abfragbar.
FAQ - Häufig gestellte Fragen zu Trino und Stackable
Wie installiere ich den Trino-Operator auf Kubernetes?
stackablectl operator install trino nutzen – damit werden auch die benötigten Commons-, Secret- und Listener-Operatoren mit ausgerollt. Helm-Charts stehen ebenfalls bereit, wenn Standard-Kubernetes-Tooling bevorzugt wird. Nach der Installation werden Cluster und Datenquellen deklarativ über die Custom Resources TrinoCluster und TrinoCatalog definiert. Auf OpenShift lässt sich der Operator über den Red Hat Certified Operators Catalog installieren.
Welche Trino-Versionen werden unterstützt?
Die unterstützten Trino-Versionen stehen auf der Seite „Supported product versions“ der Stackable-Dokumentation – mit jedem Release kommen neue hinzu, ältere werden mit der Zeit ausgemustert. Für eine bestimmte Version wird das Image in der TrinoCluster-Ressource gesetzt; Images aus einer eigenen Registry oder vollständig angepasste Images sind ebenfalls möglich. Aktuelle Liste
Wie verbinde ich mich mit Trino?
Für jede Datenquelle einen TrinoCatalog definieren (zum Beispiel einen Hive-Connector) und einen TrinoCluster, der ihn nutzt, dann über die Trino-CLI oder einen kompatiblen SQL-Client abfragen. Der Operator bindet die Catalogs in den Cluster ein, sodass die Datenquellen verfügbar sind, sobald der Cluster bereit ist.
Lassen sich mehrere Catalogs in einem einzigen Trino-Cluster betreiben?
Ja. Es lassen sich mehrere TrinoCatalog-Ressourcen definieren und mit demselben Cluster verknüpfen, sodass eine einzige SQL-Abfrage Daten aus verschiedenen Quellen verbinden und kombinieren kann – der Kern von Trinos Query-Federation.
Welche Connectoren unterstützt Trino?
Der Operator unterstützt die Trino-Connectoren, die in einer Kubernetes-Umgebung funktionieren, darunter Hive, Iceberg, Delta Lake, PostgreSQL, MySQL und mehr – jeweils als TrinoCatalog-Ressource konfiguriert.
Welche Authentifizierungsmethoden unterstützt Trino?
Trino unterstützt dateibasierte Passwort-Authentifizierung, LDAP und OAuth2, und mehrere Methoden lassen sich kombinieren, um zur jeweiligen Umgebung zu passen.
Wie wird die Autorisierung in Trino gehandhabt?
Die Autorisierung läuft über Open Policy Agent (OPA): Ein Rego-Policy-Bundle wird bereitgestellt und im TrinoCluster referenziert – das ermöglicht zentrale, feingranulare Zugriffskontrolle.
Wie funktioniert das Ressourcenmanagement in Trino?
Der Operator unterstützt Pod Disruption Budgets und Graceful Shutdown und erlaubt es, Resource Requests und Limits für Coordinators und Worker zu setzen – das hält Cluster durch Updates und Wartung stabil.
Wie skaliere ich meinen Trino-Cluster?
Die Anzahl der Worker-Replicas in der TrinoCluster-CRD erhöhen oder verringern; der Operator passt die Ressourcen entsprechend an, ohne laufende Abfragen zu stören.
Ist Monitoring in Trino integriert?
Ja. Trino stellt Prometheus-Metriken bereit, die sich mit Grafana-Dashboards für Performance-Tracking und Troubleshooting visualisieren lassen.
Lassen sich Power BI, Excel oder Tableau mit Trino verbinden?
Ja. Stackable stellt einen ODBC-Treiber für Trino (in Rust geschrieben) bereit, der Trinos REST-API in eine standardmäßige ODBC-Datenquelle verwandelt, sodass BI-Tools wie Power BI, Excel und Tableau – ebenso wie isql und Pythons pyodbc – Trino direkt abfragen können. Er läuft unter Linux und Windows, unterstützt die üblichen Authentifizierungsmethoden (Benutzername/Passwort, Bearer-Token, Client-Zertifikat oder ein OAuth-2.0-Browser-Login) und bringt einen dedizierten Power-BI-Connector mit. Siehe GitHub.
Welche Kubernetes-Plattformen unterstützt der Trino-Operator?
Der Operator wurde auf den wichtigsten managed und selbst gehosteten Kubernetes-Plattformen getestet: EKS, AKS, GKE, OpenShift, IONOS und K3s. Diese Flexibilität ermöglicht es, Trino zuverlässig über Cloud-Anbieter oder On-Premise-Infrastruktur hinweg zu deployen – bei gleichzeitigem Vorteil von deklarativem Management und Operator-Automatisierung.
Resources - So nutzt man den Stackable Operator für Trino
Getting Started Guide
Einstiegspunkt in der Doku für Setup und Quickstarts des Trino-Operators. Mit Schritt-für-Schritt-Anweisungen für die Installation.
Ein Rust-basierter ODBC-3.x-Treiber, der Trinos REST-API in eine standardmäßige ODBC-Datenquelle verwandelt – sodass Power BI, Excel, Tableau, isql und das pyodbc-Modul aus Python Trino wie jede andere Datenbank abfragen. Läuft unter Linux und Windows und bringt einen dedizierten Power-BI-Connector mit.
Das offizielle Open-Source-Repository für den Stackable Trino Operator, mit Quellcode, Helm-Charts und Beispielkonfigurationen. Ideal für Entwickler und Betreiber, die Konfigurationen erkunden, beitragen oder Deployments automatisieren möchten.
Komplette Datenpipelines, die sich mit einem stackablectl-Befehl installieren lassen – von den New Yorker Taxidaten, die per SQL über Trino abgefragt werden, bis zum Iceberg-Lakehouse mit Trino, Spark und NiFi.