




Stackable Operator für Apache Airflow
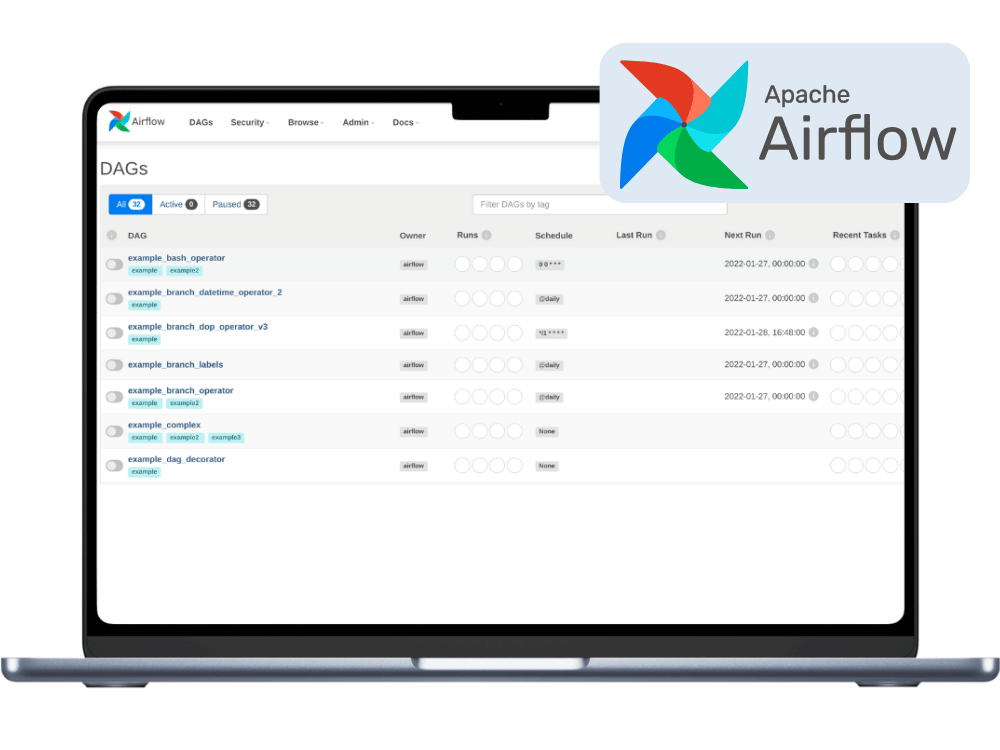
Apache Airflow® auf der
Stackable Data Platform
Airflow nativ auf Kubernetes betreiben
Der Orchestrator, der Datenpipelines steuert
Jede Pipeline muss starten, warten, wiederholen und an den nächsten Schritt übergeben, zuverlässig, bei jedem Durchlauf. Apache Airflow orchestriert genau das, und der Stackable Operator betreibt es Kubernetes-nativ: das komplette Zusammenspiel aus Webserver, Scheduler und Workern, mit Security, Logging und Ressourcen, abgestimmt auf den Produktivbetrieb. Volle Kontrolle über die Workflows, ohne den operativen Aufwand. Ob on-prem, air-gapped oder in einer souveränen Cloud, ohne Vendor-Lock-in.
Warum Apache Airflow in der Stackable Data Platform (SDP)?
Apache Airflow ist eine flexible, robuste Orchestrierungsplattform, um komplexe Datenpipelines programmatisch zu erstellen, zu planen und zu überwachen. Die Python-basierten DAGs ermöglichen dynamische, bedingte Workflows, und in der Datenplattform fungiert Airflow als zentraler Koordinator, der dafür sorgt, dass alle Schritte zuverlässig und in der richtigen Reihenfolge ablaufen.
Dynamische Workflows in Python
DAGs werden in Python definiert, mit Schleifen, Bedingungen und dynamische Pipeline-Generierung.
Skalierbare, modulare Architektur
Eine beliebige Anzahl an Workers orchestrieren und horizontal skalieren, um auch großen Workflow-Anforderungen gerecht zu werden.
Zuverlässiges Scheduling
Zeit- und ereignisgesteuerte Ausführung mit automatischen Retries, Abhängigkeitssteuerung und Backfills sorgt dafür, dass Pipelines auch bei Fehlern verlässlich durchlaufen.

Umfangreiche Integrationen
Ein breites Spektrum an Plug-and-play-Operatoren führt Tasks über Hadoop, Spark, Kubernetes und mehr aus – einschließlich der Schritte, die ML- und KI-Modelle trainieren und deployen.
Volle Transparenz
Das Web-Interface überwacht, plant und verwaltet Workflows, mit vollem Einblick in Status und Logs abgeschlossener und laufender Tasks.
Offen & community-driven
Ein Projekt der Apache Software Foundation mit einer lebendigen Community.
Was bringt der Stackable Operator für Apache Airflow mit?
Executor je Workload wählen
Den Celery-Executor (mit Redis) für gleichmäßig verteilten Durchsatz wählen oder den Kubernetes-Executor, der pro Task einen isolierten Pod startet, für elastische Skalierung und Workload-Isolation. Der Wechsel erfolgt deklarativ in der CRD.
Airflow als Control Plane der Plattform
Aus einem einzigen DAG heraus eine SparkApplication-CRD starten, Ingestion in NiFi auslösen oder Datasets über Trino abfragen. Airflow steuert die anderen Stackable-Operatoren, nicht nur Python-Tasks.

GitOps-freundliche DAG-Bereitstellung
DAGs deklarativ einbinden, aus versionierten ConfigMaps oder über einen git-sync-Sidecar, der sie aus dem Repository zieht. Die Bereitstellung bleibt reproduzierbar und auditierbar.
Was haben alle Stackable-Operatoren gemeinsam?
Ein Operator-Framework (Rust)
Jeder Operator folgt demselben CRD-Muster mit Roles, RoleGroups und ConfigOverrides. Wer einen Operator kennt, findet sich sofort im nächsten zurecht.
Infrastructure-as-Code
Jede Data-App ist eine YAML-CRD, die in Git lebt – reviewbar, lintbar und CI/CD-fähig, mit eingebauten Validierungsregeln, die Fehlkonfigurationen früh abfangen. Dieselbe Definition funktioniert auf Dev, Test und Prod.

Lifecycle-Management (Day-2 Operations)
Deployment, Restarts, Zertifikatsrotation und Rolling Upgrades laufen automatisch – inklusive Pod-Restarts, wenn sich Configs oder Secrets ändern. Und weil man sehen muss, was läuft, ist Monitoring & Logging gleich mit dabei: Prometheus, Vector und OpenTelemetry speisen fertige Grafana-Dashboards – ein Observability-Setup für die ganze Plattform.
Security by default:
TLS, Kerberos für HDFS, OIDC-Login und OPA-basierte, feingranulare Autorisierung, alles pro CRD konfigurierbar. Tägliche Vulnerability-Scans, SBOMs und mit cosign signierte Images halten die ganze Plattform gepatcht – man muss nicht selbst ein Dutzend Upstream-Projekte im Blick behalten.

Kubernetes-native und modular
Läuft on-prem, in jeder Cloud oder auf einem Laptop, ohne Vendor-Lock-in – mit explizitem air-gapped Support. Nur die benötigten Operatoren installieren und später weitere hinzufügen, ohne den Rest anzufassen.
OpenShift-zertifiziert
Alle Operatoren sind Red-Hat-zertifiziert und direkt über den Red Hat Certified Operators Catalog (OperatorHub) installierbar – kompatibel mit Security Context Constraints und RBAC. Zertifizierter Betrieb über eine Stackable-Subscription.
Use Cases für Airflow
Datenpipelines orchestrieren
ETL- und ELT-Workflows automatisieren – Daten aus vielen Quellen sammeln, bereinigen und in HBase, OpenSearch oder den Data Lake laden. Mit Airflow skalieren diese Deployments zuverlässig mit wachsenden Workloads.
Machine-Learning- & KI-Workflows planen
Data-Science-Teams planen und überwachen End-to-End-Pipelines, von der Feature-Extraktion bis zu Modell-Training und -Deployment. Der Operator sorgt für Hochverfügbarkeit und saubere Integration mit Spark, Trino und weiteren Engines.
Echtzeit & Batch an einem Ort
Airflow koordiniert Jobs über Kafka, Spark und Superset hinweg, sodass Streaming- und Batch-Prozesse nebeneinander laufen und Daten nahtlos von der Ingestion bis zur Visualisierung fließen.
FAQ - Häufig gestellte Fragen zu Airflow und Stackable
Empfohlen wird stackablectl, die CLI von Stackable. Sie installiert den Airflow-Operator zusammen mit allen benötigten Operatoren in einem Schritt. Ein Stackable-Data-Platform-Release liefert dabei einen Satz an Operator-Versionen, die auf Kompatibilität getestet sind. Wer lieber mit Helm arbeitet, findet ein Helm-Chart. So lässt sich Airflow in jeder Kubernetes-Umgebung einfach deployen, ohne manuelles Jonglieren mit Abhängigkeiten. Auf OpenShift lässt sich der Operator über den Red Hat Certified Operators Catalog installieren.
Der Stackable Operator unterstützt den CeleryExecutor für verteilte Task-Ausführung über einen Pool von Worker-Pods, die über Redis verbunden sind, und den KubernetesExecutor, der pro Task dynamisch einen neuen Pod startet – für elastische Skalierung und Workload-Isolation. Da beide in den Operator integriert sind, lässt sich der Ausführungsmodus deklarativ umschalten und die Ressourcen skalieren, ohne das Deployment neu zu strukturieren.
DAGs lassen sich deklarativ in der AirflowCluster-CRD mounten: ConfigMaps eignen sich ideal für statische, versionierte DAGs, während git-sync-Sidecars DAGs kontinuierlich aus einem Git-Repository beziehen – für GitOps-artige Workflows. Der deklarative Ansatz von Stackable hält die DAG-Verteilung reproduzierbar und auditierbar und vollständig in die Kubernetes-Workflows integriert.
Nach dem Deployment von Airflow mit dem Stackable Operator lassen sich über den Getting-Started-Guide die Beispiel-DAGs ausführen, die mit dem Operator paketiert sind. Sie sind bereits so konfiguriert, dass sie Kubernetes-natives Scheduling demonstrieren, und lassen sich direkt aus der Airflow-UI oder -API auslösen – ein reproduzierbarer Einstieg in die Orchestrierung von Jobs auf der Stackable-Plattform.
Absolut. Mit dem Stackable Operator wird Airflow zur Orchestrierungsschicht für die gesamte Stackable Data Platform. Aus einem DAG heraus lässt sich eine SparkApplication-CRD starten, Daten-Ingestion in NiFi auslösen oder Datasets über Trino abfragen. Diese enge Integration macht Airflow zur zentralen Control Plane über verteilte Datenpipelines hinweg – weit mehr als nur ein Scheduler für Python-Tasks.
Der Operator nutzt ListenerClasses, Stackables Abstraktion für die Verwaltung von Ingress und Service-Exposure. Ob NodePort, LoadBalancer oder Integration mit einem Ingress-Controller – der externe Zugriff lässt sich deklarativ in der CRD konfigurieren. Das hält das Networking-Setup über die gesamte Stackable-Plattform konsistent und im Einklang mit Sicherheitsrichtlinien auf Enterprise-Niveau.
Der Operator liefert für die Airflow-Komponenten Default-Resource-Requests und -Limits, sodass selbst kleine Cluster mit sinnvollen Voreinstellungen starten. Für den Produktivbetrieb enthält die Doku minimale HA-Beispiele und Tuning-Hinweise für Scheduler und Workers. Mit Kubernetes-nativer Skalierung und vom Operator verwalteten Pod Disruption Budgets wachsen Airflow-Cluster elastisch und bleiben zugleich während Upgrades und Node-Ausfällen stabil.
Ja. Der Stackable Operator integriert Kubernetes-native Best Practices wie preStop-Hooks und Termination-Grace-Periods und stimmt sich mit dem Lifecycle-Management des Operators ab, sodass Scheduler und Workers aktive Tasks abschließen, bevor sie beendet werden. Das macht Rolling Upgrades und Wartungsfenster sicherer und planbarer, verhindert Job-Verluste und hält Workflows konsistent.
Jeder Airflow-Pod läuft mit einem Vector-Sidecar, der Standard-Logging-Lösung von Stackable. Logs lassen sich an Elasticsearch, OpenSearch, S3 oder andere Backends weiterleiten – für einheitliche Observability über die gesamte Datenplattform. Airflow-Logs werden auf dieselbe Weise gesammelt, angereichert und ausgeliefert wie bei Kafka, Spark, NiFi und anderen Stackable-Komponenten, was Monitoring und Troubleshooting vereinfacht.
Ja. Jede Airflow-Komponente wird mit einem Metrics-Sidecar deployt, der sich nahtlos in die von Stackable bereitgestellten Prometheus- und Grafana-Dashboards einfügt. So gibt es Observability out of the box für Scheduler-Performance, DAG-Laufzeit-Metriken, Worker-Last und Cluster-Health – ohne zusätzlichen Aufwand.
Ja. Der Stackable Operator unterstützt den KubernetesExecutor und ergänzt dabei persistente Logging-Optionen. Task-Logs lassen sich über die integrierte Logging-Integration von Stackable in S3, MinIO oder PVCs speichern, sodass Logs selbst bei kurzlebigen Task-Pods für Debugging, Auditing und Compliance zugänglich bleiben.
Die vollständige Spezifikation der AirflowCluster Custom Resource steht in der Stackable CRD-Referenz. Sie dokumentiert jedes konfigurierbare Feld – von Executors und Dependency-Management (PostgreSQL, Redis) bis zu Logging, TLS und Monitoring – sodass sich produktionsreife Cluster mit derselben Konsistenz wie jede andere Kubernetes-Ressource deklarativ definieren lassen.
CRD-Referenz
Die unterstützten Apache-Airflow-Versionen stehen auf der Seite „Supported product versions“ der Stackable-Dokumentation, die mit jedem Release aktualisiert wird, sobald neue Versionen erscheinen und ältere abgekündigt werden. Die Version wird über das Image in der AirflowCluster-Ressource gewählt; eigene Registries und eigene Images werden ebenfalls unterstützt.
Aktuelle Liste
Airflow-Deployments mit dem Stackable Operator lassen sich absichern über: integriertes Nutzer- und Rollen-Management für schnelles Setup; LDAP- oder OIDC-Integration für Enterprise-SSO und zentrales Identity-Management. Durch die Wiederverwendung derselben Identity-Provider-Integrationen, die im gesamten Stackable-Ökosystem verfügbar sind, entsteht einheitliche Authentifizierung und Autorisierung über alle Plattformkomponenten hinweg.
Der Operator wurde auf den wichtigsten managed und selbst gehosteten Kubernetes-Plattformen getestet: EKS, AKS, GKE, OpenShift, IONOS und K3s. Diese Flexibilität ermöglicht es, Airflow zuverlässig über Cloud-Anbieter oder On-Premise-Infrastruktur hinweg zu deployen – bei gleichzeitigem Vorteil von deklarativem Management und Operator-Automatisierung.
Resources - So nutzt man den Stackable Operator für Apache Airflow
Getting Started & Installation
Den Stackable Airflow Operator (mit PostgreSQL und Redis) über stackablectl, Helm oder OpenShift installieren, dann den ersten Apache-Airflow-Cluster deployen und einen Beispiel-DAG ausführen. Enthält Setup-Schritte und Konfigurationsbeispiele.
Airflow-Operator-Doku
Überblick über den Stackable Airflow Operator, einschließlich unterstützter Rollen, Executor-Typen und zentraler Funktionen für den Betrieb von Airflow auf Kubernetes.
GitHub Repository
Offizielles GitHub-Repository für den Stackable Airflow Operator, mit Quellcode, Dokumentation und Konfigurationsbeispielen.
Demo
Dieses Beispiel eines geplanten Jobs in Apache Airflow zeigt, wie sich Tasks mit dem Stackable Airflow Operator definieren, planen und ausführen lassen.
Zum Newsletter anmelden
Newsletter
Zum Newsletter anmelden
Mit dem Stackable Newsletter bist Du immer auf dem Laufenden, wenn es um Updates rund um Stackable geht!