Stackable
Now available: Stackable Data Platform 26.7 → SLSA provenance, dynamic image repositories & more!
Jetzt verfügbar: Stackable Data Platform 26.7 → SLSA-Provenance, dynamische Image-Repositories & mehr!
Stackable und JupyterHub
Eine Multi-User-Data-Science-Umgebung: JupyterHub mit Keycloak-Single-Sign-on, das Apache-Spark-Jobs direkt aus dem Notebook gegen Daten in HDFS startet.
SO GEHT'S LOS
Mit einem Kubernetes-Cluster genügt ein einziger Befehl:
Funktionen
Multi-User-Notebooks
Pro Nutzer:in ein isolierter JupyterLab-Server, bei Bedarf von JupyterHub bereitgestellt.
Spark direkt aus dem Notebook
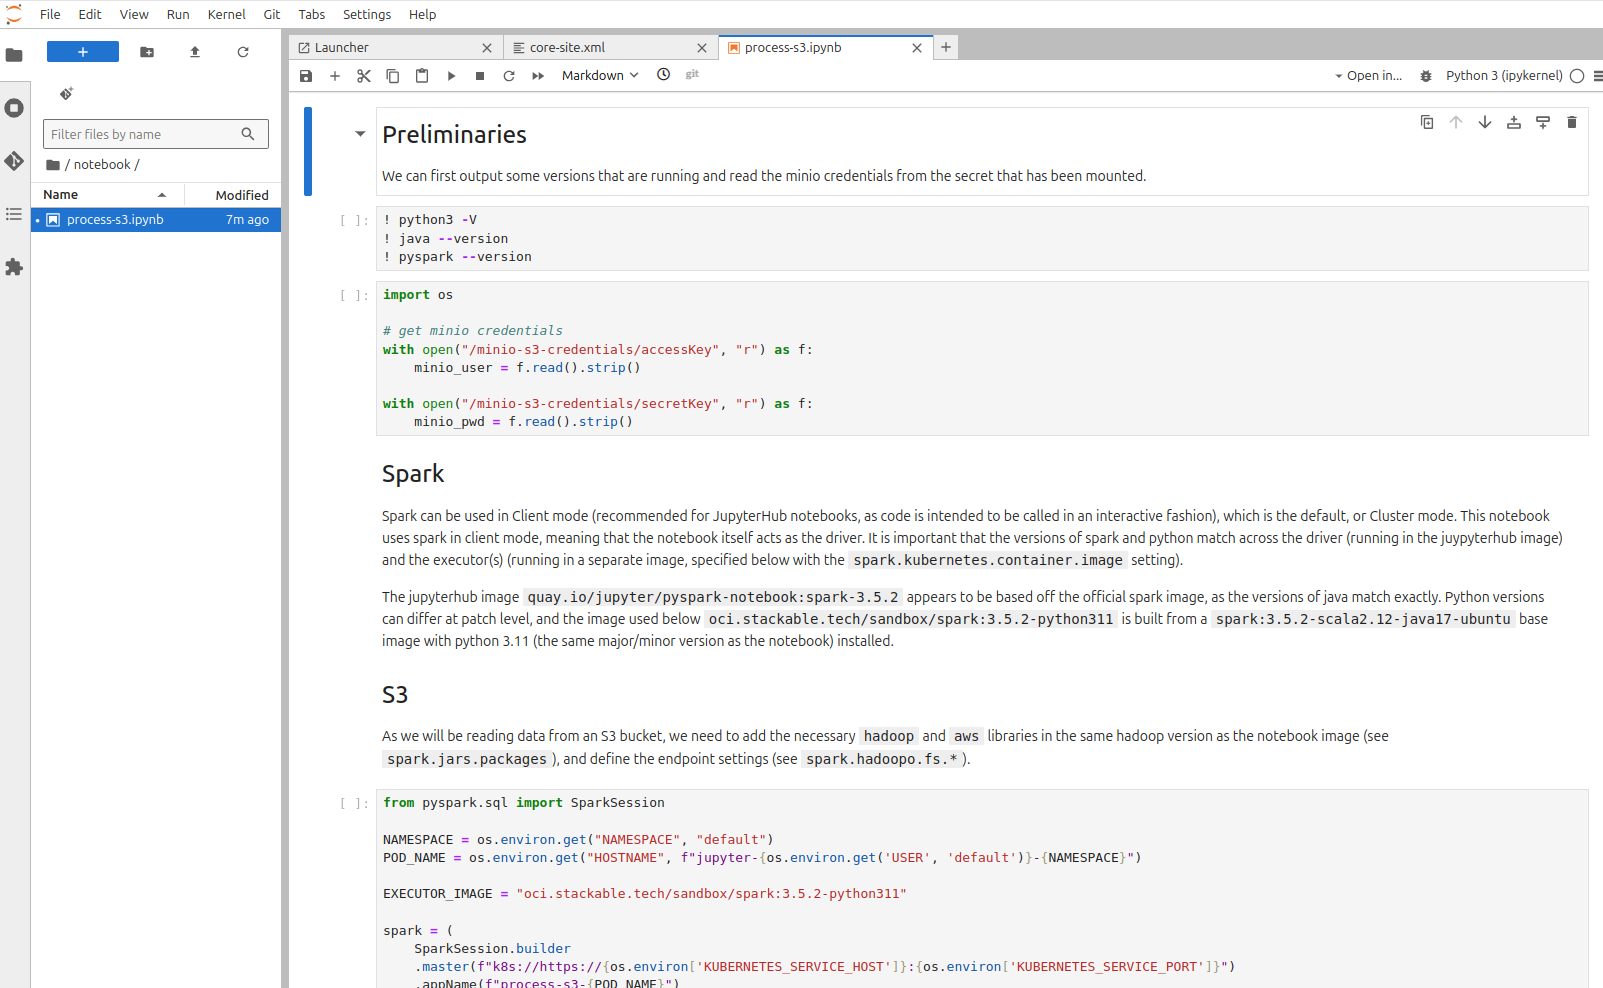
Starte verteilte Spark-Jobs aus einer Notebook-Zelle heraus.
Reproduzierbare Images
Feste, kuratierte Container-Images für jede Sitzung.
Single Sign-on
Login per Keycloak-OIDC, ohne geteilte Zugangsdaten.
HDFS als Speicher
Lies und schreibe große Datensätze auf einem echten Hadoop-Dateisystem.
Isolierte Ressourcen
Pro Nutzer:in CPU-/Speicher-Limits halten den Cluster fair.
Demo-Komponenten
JupyterHub
Notebook-Hub
Stellt isolierte Single-User-JupyterLab-Server bereit und verwaltet deren Lebenszyklus.
Keycloak
Identität
OIDC-Identity-Provider für Authentifizierung und Nutzer-Föderation.
Apache Spark
Compute
Verteilte Verarbeitung, aus Notebooks über den Stackable-Spark-Operator gestartet.
Apache HDFS
Speicher
Verteiltes Dateisystem, das die Demo-Datensätze hält.
Demo-Ablauf
Installation
Ein stackablectl-Befehl installiert JupyterHub, Keycloak, Spark und HDFS.
Login per Keycloak
Melde dich per SSO an; JupyterHub stellt deinen persönlichen Notebook-Server bereit.
Notebook starten
Öffne JupyterLab und wähle ein kuratiertes, reproduzierbares Image.
Spark-Job absenden
Starte einen verteilten Spark-Job direkt aus einer Notebook-Zelle.
Ergebnisse lesen
Lade die Ausgabe aus HDFS zurück und erkunde sie im Notebook.
Gib deinen Data Scientists geregelte Self-Service-Notebooks mit Spark und HDFS im Rücken.